Musikquellentrennung mit KI
Praxis-Tutorial zur KI-Musikquelltrennung mit Hybrid Demucs: Songs in Gesang, Drums, Bass und weitere Stems aufteilen — mit vollständigem Code, Spektrogrammen und Hörergebnissen.
Auf dieser Seite
- 1. Einleitung
- 2. Umgebungseinrichtung
- 3. Laden des Hybrid-Demucs-Modells
- 4. Aufbau der Audio-Separations-Pipeline
- 4.1 Implementierung der Trennfunktion
- 5. Spektrogramm-Visualisierung
- 6. Ausführung der Quellentrennung
- 7. Modellausgaben
- 8. Spektrogramm-Analyse
- 9. Extraktion des Audio-Segments
- 10. Darstellung von Spektrogrammen und Audio
- 11. Spektrogramm der Mischung
- 12. Ergebnisse der Drum-Trennung
- 13. Ergebnisse der Bass-Trennung
- 14. Ergebnisse der Vocal-Trennung
- 15. Ergebnisse des übrigen Begleitmaterials
- 16. Wiedergabe des vollständigen Audios
- 17. Fazit
- Referenzen
- 1. Hybrid Demucs
- [1] Hybrid Spectrogram and Waveform Source Separation
- [2] Music Source Separation in the Waveform Domain
- 2. Datensatz-Referenzen
- [3] The MUSDB18 Corpus for Music Separation
- 3. PyTorch-/Torchaudio-Dokumentation
- [4] Torchaudio Offizielle Dokumentation
- [5] Offizielles Hybrid-Demucs-Tutorial
- 4. Klassische Forschung zur Musikquellentrennung
- [6] Open-Unmix — A Reference Implementation for Music Source Separation
- [7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
- 5. Evaluationsmetriken
- [8] BSS Eval Metrics
- 6. Deep Learning für die Audioverarbeitung
- [9] Deep Learning for Audio Signal Processing
- [10] Fundamentals of Music Processing
- 7. Empfohlene Ressourcen für weiterführendes Studium
Autor-Referenz: Sean Kim
Modell-Referenz: Hybrid Demucs (Défossez, 2021)
1. Einleitung
Dieses Tutorial zeigt, wie man eine Musikquellentrennung mit dem Hybrid Demucs-Modell durchführt. Ziel ist es, einen gemischten Musiktrack in seine einzelnen Stems zu zerlegen, darunter:
- Vocals
- Drums
- Bass
- Weitere Begleitelemente
Der komplette Workflow besteht aus folgenden Phasen:
- Initialisierung des Hybrid-Demucs-Trennmodells
- Aufteilung langer Audios in überlappende Chunks
- Chunk-weise Modellinferenz
- Rekonstruktion des vollständigen Audios aus allen Segmenten
- Export der getrennten Stems und Visualisierung der Spektrogramme
Hybrid Demucs ist eine erweiterte Version der ursprünglichen Demucs-Architektur.
Sie kombiniert:
- Wellenform-basierte convolutive Modellierung
- Merkmalslernen im Spektrogrammbereich
Durch die gemeinsame Nutzung von Zeit- und Frequenzbereichsdarstellungen erreicht Hybrid Demucs eine deutlich natürlichere und höherwertige Quellentrennung als herkömmliche Ansätze.
Weiterführende Ressourcen:
- Hybrid-Demucs-Paper: https://arxiv.org/abs/2111.03600
- Offizielles Repository: https://github.com/facebookresearch/demucs
2. Umgebungseinrichtung
Installieren Sie die erforderlichen Abhängigkeiten:
pip install torch torchaudio matplotlibImportieren Sie die benötigten Module:
import torch
import torchaudio
import matplotlib.pyplot as plt

from IPython.display import Audio
from torchaudio.pipelines import HDEMUCS_HIGH_MUSDB_PLUS
from torchaudio.utils import _download_asset
Prüfen Sie die installierten Versionen:
print(torch.__version__)
print(torchaudio.__version__)
3. Laden des Hybrid-Demucs-Modells
Torchaudio bietet eine vortrainierte Hybrid-Demucs-Pipeline out of the box:
bundle = HDEMUCS_HIGH_MUSDB_PLUS
model = bundle.get_model()
Das ausgewählte Modell:
- Wurde auf dem MUSDB18-HQ-Datensatz trainiert
- Enthält zusätzliche proprietäre Augmentierungsdaten
- Ist für hochwertige 44.1-kHz-Audioverarbeitung optimiert
Modellkonfiguration:
- FFT-Größe: 4096
- Netzwerktiefe: 6
Konfigurieren Sie das Ausführungsgerät:
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
model.to(device)

sample_rate = bundle.sample_rate

print(f"Sample rate: {sample_rate}")
4. Aufbau der Audio-Separations-Pipeline
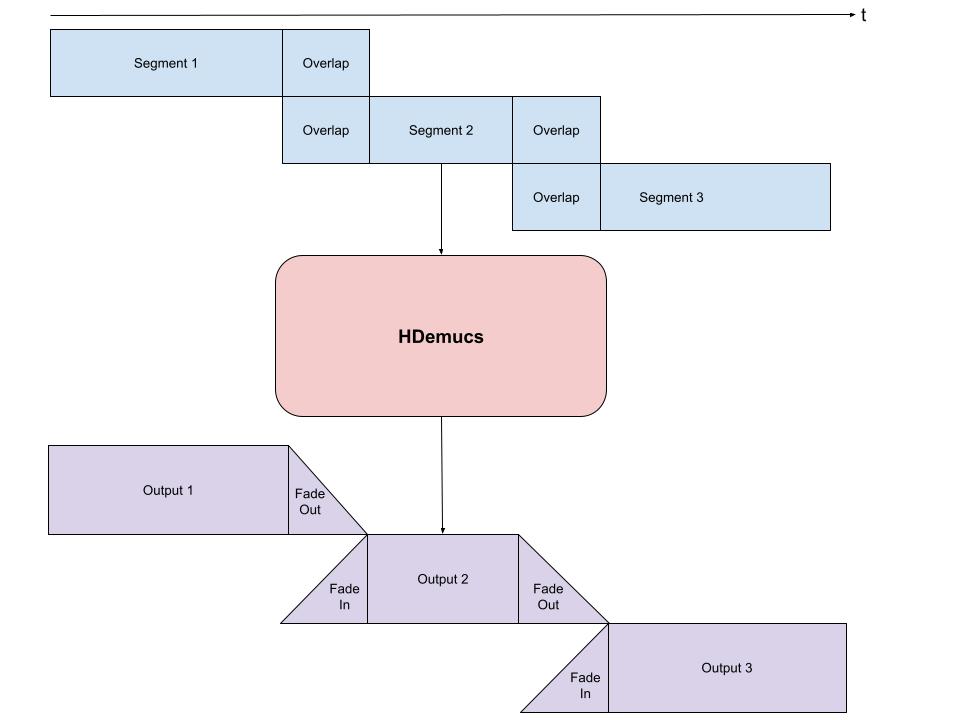
Da HDemucs rechenintensiv und speicherhungrig ist, ist die Inferenz über ein gesamtes Lied in einem einzigen Durchlauf oft unpraktisch.
In realen Deployments wird langes Audio typischerweise verarbeitet mit:
- Chunk-basierter Segmentierung
- Überlappenden Fenstern
- Fade-in-/Fade-out-Glättung
Diese Strategie ist notwendig, weil:
- Neuronale Modelle dazu neigen, an Segmentgrenzen Artefakte zu erzeugen
- Überlappende Bereiche helfen, Diskontinuitäten und Grenzrauschen zu reduzieren
Die Verarbeitungsstrategie ist unten illustriert:
4.1 Implementierung der Trennfunktion
from torchaudio.transforms import Fade


def separate_sources(
    model,
    mix,
    segment=10.0,
    overlap=0.1,
    device=None,
):
    """
    Perform music source separation using chunked inference.

    Args:
        segment: Length of each audio chunk in seconds
        overlap: Overlap ratio between consecutive chunks
        device: Inference device
    """

    if device is None:
        device = mix.device
    else:
        device = torch.device(device)

    batch, channels, length = mix.shape

    chunk_len = int(sample_rate * segment * (1 + overlap))

    start = 0
    end = chunk_len

    overlap_frames = overlap * sample_rate

    fade = Fade(
        fade_in_len=0,
        fade_out_len=int(overlap_frames),
        fade_shape="linear",
    )

    final = torch.zeros(
        batch,
        len(model.sources),
        channels,
        length,
        device=device,
    )

    while start < length - overlap_frames:

        chunk = mix[:, :, start:end]

        with torch.no_grad():
            out = model.forward(chunk)

        out = fade(out)

        final[:, :, :, start:end] += out

        if start == 0:
            fade.fade_in_len = int(overlap_frames)
            start += int(chunk_len - overlap_frames)
        else:
            start += chunk_len

        end += chunk_len

        if end >= length:
            fade.fade_out_len = 0

    return final
5. Spektrogramm-Visualisierung
Definieren Sie eine Hilfsfunktion zur Spektrogramm-Visualisierung:
def plot_spectrogram(stft, title="Spectrogram"):
    magnitude = stft.abs()

    spectrogram = 20 * torch.log10(
        magnitude + 1e-8
    ).numpy()

    _, axis = plt.subplots(1, 1)

    axis.imshow(
        spectrogram,
        cmap="viridis",
        vmin=-60,
        vmax=0,
        origin="lower",
        aspect="auto",
    )

    axis.set_title(title)

    plt.tight_layout()
6. Ausführung der Quellentrennung
Verwenden Sie die offizielle Demo-Audiodatei von Torchaudio:
SAMPLE_SONG = _download_asset(
    "tutorial-assets/hdemucs_mix.wav"
)

waveform, sample_rate = torchaudio.load(SAMPLE_SONG)

waveform = waveform.to(device)

mixture = waveform
Konfigurieren Sie die Inferenzparameter:
segment = 10
overlap = 0.1
Normalisieren Sie die Wellenform:
ref = waveform.mean(0)

waveform = (
    waveform - ref.mean()
) / ref.std()
Führen Sie die Quellentrennung aus:
sources = separate_sources(
    model,
    waveform[None],
    device=device,
    segment=segment,
    overlap=overlap,
)[0]

sources = sources * ref.std() + ref.mean()
Speichern Sie die getrennten Stems:
sources_list = model.sources

sources = list(sources)

audios = dict(zip(sources_list, sources))
7. Modellausgaben
Das Standard-Hybrid-Demucs-Modell erzeugt vier Stems:
| Stem | Beschreibung |
|---|---|
| drums | Percussion- und Drum-Spuren |
| bass | Bassinstrumente |
| vocals | Lead- und Backing-Vocals |
| other | Verbleibendes Begleitmaterial |
8. Spektrogramm-Analyse
Konfigurieren Sie die STFT-Parameter:
N_FFT = 4096
N_HOP = 4

stft = torchaudio.transforms.Spectrogram(
    n_fft=N_FFT,
    hop_length=N_HOP,
    power=None,
)
9. Extraktion des Audio-Segments
Extrahieren Sie das Segment zwischen 150 s und 155 s:
segment_start = 150
segment_end = 155

frame_start = segment_start * sample_rate
frame_end = segment_end * sample_rate
Laden Sie die entsprechenden Referenz-Stems:
drums_original = _download_asset(
    "tutorial-assets/hdemucs_drums_segment.wav"
)

bass_original = _download_asset(
    "tutorial-assets/hdemucs_bass_segment.wav"
)

vocals_original = _download_asset(
    "tutorial-assets/hdemucs_vocals_segment.wav"
)

other_original = _download_asset(
    "tutorial-assets/hdemucs_other_segment.wav"
)
Extrahieren Sie die vorhergesagten Segmente:
drums_spec = audios["drums"][:, frame_start:frame_end].cpu()
bass_spec = audios["bass"][:, frame_start:frame_end].cpu()
vocals_spec = audios["vocals"][:, frame_start:frame_end].cpu()
other_spec = audios["other"][:, frame_start:frame_end].cpu()

mix_spec = mixture[:, frame_start:frame_end].cpu()
10. Darstellung von Spektrogrammen und Audio
Definieren Sie eine Utility-Funktion für Visualisierung und Wiedergabe:
def output_results(
    original_source: torch.Tensor,
    predicted_source: torch.Tensor,
    source: str,
):

    plot_spectrogram(
        stft(predicted_source)[0],
        f"Spectrogram - {source}"
    )

    return Audio(
        predicted_source,
        rate=sample_rate
    )
11. Spektrogramm der Mischung
plot_spectrogram(
    stft(mix_spec)[0],
    "Spectrogram - Mixture"
)

Audio(mix_spec, rate=sample_rate)
12. Ergebnisse der Drum-Trennung
output_results(
    drums,
    drums_spec,
    "drums"
)
13. Ergebnisse der Bass-Trennung
output_results(
    bass,
    bass_spec,
    "bass"
)
14. Ergebnisse der Vocal-Trennung
output_results(
    vocals,
    vocals_spec,
    "vocals"
)
15. Ergebnisse des übrigen Begleitmaterials
output_results(
    other,
    other_spec,
    "other"
)
16. Wiedergabe des vollständigen Audios
Um die kompletten getrennten Stems anzuhören, kommentieren Sie den folgenden Code aus:
# Original mixture
# Audio(mixture, rate=sample_rate)

# Drums
# Audio(audios["drums"], rate=sample_rate)

# Bass
# Audio(audios["bass"], rate=sample_rate)

# Vocals
# Audio(audios["vocals"], rate=sample_rate)

# Other accompaniment
# Audio(audios["other"], rate=sample_rate)
17. Fazit
Hybrid Demucs integriert:
- Wellenform-basierte convolutive Modellierung
- Spektrogrammbasiertes Lernen im Frequenzbereich
Verglichen mit traditionellen Ansätzen der Quellentrennung bietet es:
- Höhere Trenntreue
- Sauberere Vocal-Isolation
- Weniger Begleit-Übersprechen
Dieses Tutorial nutzt zusätzlich praktische Engineering-Strategien wie:
- Chunk-basierte Inferenz
- Overlap-Rekonstruktion
- Fade-Glättung
Diese Techniken adressieren effektiv die Herausforderungen der Inferenz bei langem Audio und eignen sich hervorragend für reale Deployment-Szenarien.
Typische Anwendungen umfassen:
- KI-Gesangsstimmenkonvertierung
- Vocal-Extraktion
- Karaoke-Erstellung
- Musik-Remixing
- Automatisches Arrangement
- Audio-Nachbearbeitung
Referenzen
Die folgenden Referenzen decken Hybrid Demucs, Musikquellentrennung und Deep-Learning-basierte Audioverarbeitung ab.
1. Hybrid Demucs
[1] Hybrid Spectrogram and Waveform Source Separation
Autor: Alexandre Défossez
Veranstaltung: ISMIR 2021 Workshop
Jahr: 2021
Défossez, A. (2021).
Hybrid Spectrogram and Waveform Source Separation.
arXiv preprint arXiv:2111.03600.
Paper:
https://arxiv.org/abs/2111.03600
Diese Arbeit stellte die Hybrid-Demucs-Architektur vor, die kombiniert:
- Wellenform-basierte Faltung
- Repräsentationslernen im Spektrogrammbereich
Sie zählt weiterhin zu den einflussreichsten Architekturen der modernen Musikquellentrennung.
[2] Music Source Separation in the Waveform Domain
Autoren: Alexandre Défossez, Nicolas Usunier, Léon Bottou, Francis Bach
Konferenz: ISMIR 2019
Jahr: 2019
Défossez, A., Usunier, N., Bottou, L., & Bach, F. (2019).
Music Source Separation in the Waveform Domain.
Proceedings of the 20th International Society for Music Information Retrieval Conference (ISMIR).
Paper:
https://arxiv.org/abs/1911.13254
Dieses Paper stellte die ursprüngliche Demucs-Architektur vor und begründete die wellenformbasierte End-to-End-Musikquellentrennung.
2. Datensatz-Referenzen
[3] The MUSDB18 Corpus for Music Separation
Autoren: Zafar Rafii et al.
Datensatz: MUSDB18-HQ
Jahr: 2017
Rafii, Z., Liutkus, A., Stöter, F.-R., Mimilakis, S. I.,
Bittner, R., & Pardo, B. (2017).
The MUSDB18 Corpus for Music Separation.
Datensatz:
https://zenodo.org/record/3338373
MUSDB18-HQ ist einer der am weitesten verbreiteten Benchmark-Datensätze der Musikquellentrennungsforschung.
3. PyTorch-/Torchaudio-Dokumentation
[4] Torchaudio Offizielle Dokumentation
PyTorch Audio Team.
Torchaudio Documentation.
Dokumentation:
https://pytorch.org/audio/stable/index.html
[5] Offizielles Hybrid-Demucs-Tutorial
PyTorch Audio Team.
Music Source Separation with Hybrid Demucs.
Tutorial:
https://docs.pytorch.org/audio/stable/tutorials/hybrid_demucs_tutorial.html
Die Implementierungsstruktur und der experimentelle Workflow dieses Artikels sind teilweise vom offiziellen Tutorial inspiriert.
4. Klassische Forschung zur Musikquellentrennung
[6] Open-Unmix — A Reference Implementation for Music Source Separation
Autoren: Fabian-Robert Stöter et al.
Journal: Journal of Open Source Software
Jahr: 2019
Stöter, F.-R., Liutkus, A., & Ito, N. (2019).
The 2018 Signal Separation Evaluation Campaign.
Journal of Open Source Software.
Projekt:
https://sigsep.github.io/open-unmix/
[7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
Autoren: Andreas Jansson et al.
Konferenz: ISMIR 2017
Jansson, A., Humphrey, E., Montecchio, N.,
Bittner, R., Kumar, A., & Weyde, T. (2017).
Singing Voice Separation with Deep U-Net Convolutional Networks.
Paper:
https://ismir2017.smcnus.org/wp-content/uploads/2017/10/171_Paper.pdf
5. Evaluationsmetriken
[8] BSS Eval Metrics
Vincent, E., Gribonval, R., & Févotte, C. (2006).
Performance Measurement in Blind Audio Source Separation.
IEEE Transactions on Audio, Speech, and Language Processing.
Paper:
https://ieeexplore.ieee.org/document/1643671
Diese Arbeit führte mehrere klassische Evaluationsmetriken für die Quellentrennung ein, darunter:
- SDR (Signal-to-Distortion Ratio)
- SIR (Signal-to-Interference Ratio)
- SAR (Signal-to-Artifacts Ratio)
6. Deep Learning für die Audioverarbeitung
[9] Deep Learning for Audio Signal Processing
Kellman, M., et al.
Deep Learning for Audio Signal Processing.
Verlag:
Cambridge University Press
[10] Fundamentals of Music Processing
Müller, M. (2015).
Fundamentals of Music Processing.
Springer.
Buch-Website:
https://www.music-processing.de/
7. Empfohlene Ressourcen für weiterführendes Studium
| Thema | Ressource |
|---|---|
| Demucs Offizielles Repository | https://github.com/facebookresearch/demucs |
| PyTorch Audio | https://pytorch.org/audio/stable/index.html |
| Source Separation Community | https://sigsep.github.io/ |
| MUSDB Dataset | https://zenodo.org/record/3338373 |
| ISMIR Society | https://ismir.net/ |