Separación de fuentes musicales con IA
Guía práctica de separación de fuentes musicales con IA usando Hybrid Demucs: divide canciones en voz, batería, bajo y otros stems, con código completo, espectrogramas y resultados.
En esta página
- 1. Introducción
- 2. Configuración del entorno
- 3. Carga del modelo Hybrid Demucs
- 4. Construcción de la pipeline de separación de audio
- 4.1 Implementación de la función de separación
- 5. Visualización del espectrograma
- 6. Ejecución de la separación de fuentes
- 7. Salidas del modelo
- 8. Análisis del espectrograma
- 9. Extracción del segmento de audio
- 10. Renderizado de espectrogramas y audio
- 11. Espectrograma de la mezcla
- 12. Resultados de la separación de batería
- 13. Resultados de la separación de bajo
- 14. Resultados de la separación vocal
- 15. Resultados del acompañamiento restante
- 16. Reproducción del audio completo
- 17. Conclusión
- Referencias
- 1. Hybrid Demucs
- [1] Hybrid Spectrogram and Waveform Source Separation
- [2] Music Source Separation in the Waveform Domain
- 2. Referencias de datasets
- [3] The MUSDB18 Corpus for Music Separation
- 3. Documentación de PyTorch / Torchaudio
- [4] Documentación oficial de Torchaudio
- [5] Tutorial oficial de Hybrid Demucs
- 4. Investigación clásica en separación de fuentes musicales
- [6] Open-Unmix — A Reference Implementation for Music Source Separation
- [7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
- 5. Métricas de evaluación
- [8] BSS Eval Metrics
- 6. Deep learning para el procesamiento de audio
- [9] Deep Learning for Audio Signal Processing
- [10] Fundamentals of Music Processing
- 7. Recursos recomendados para profundizar
Referencia del autor: Sean Kim
Referencia del modelo: Hybrid Demucs (Défossez, 2021)
1. Introducción
Este tutorial demuestra cómo realizar la separación de fuentes musicales usando el modelo Hybrid Demucs. El objetivo es descomponer una pista musical mezclada en sus stems constituyentes, incluyendo:
- Voces
- Batería
- Bajo
- Otros componentes de acompañamiento
El flujo de trabajo completo consta de las siguientes etapas:
- Inicialización del modelo de separación Hybrid Demucs
- División del audio largo en fragmentos superpuestos
- Inferencia del modelo por fragmentos
- Reconstrucción del audio completo a partir de todos los segmentos
- Exportación de los stems separados y visualización de espectrogramas
Hybrid Demucs es una versión mejorada de la arquitectura Demucs original.
Combina:
- Modelado convolucional en el dominio de la forma de onda
- Aprendizaje de características en el dominio del espectrograma
Al aprovechar conjuntamente las representaciones del dominio temporal y de la frecuencia, Hybrid Demucs logra una separación de fuentes notablemente más natural y de mayor fidelidad que los enfoques convencionales.
Recursos relacionados:
- Paper de Hybrid Demucs: https://arxiv.org/abs/2111.03600
- Repositorio oficial: https://github.com/facebookresearch/demucs
2. Configuración del entorno
Instala las dependencias necesarias:
pip install torch torchaudio matplotlibImporta los módulos necesarios:
import torch
import torchaudio
import matplotlib.pyplot as plt

from IPython.display import Audio
from torchaudio.pipelines import HDEMUCS_HIGH_MUSDB_PLUS
from torchaudio.utils import _download_asset
Comprueba las versiones instaladas:
print(torch.__version__)
print(torchaudio.__version__)
3. Carga del modelo Hybrid Demucs
Torchaudio proporciona una pipeline Hybrid Demucs preentrenada lista para usar:
bundle = HDEMUCS_HIGH_MUSDB_PLUS
model = bundle.get_model()
El modelo seleccionado:
- Está entrenado en el dataset MUSDB18-HQ
- Incluye datos de aumento propietarios adicionales
- Está optimizado para procesamiento de audio de alta calidad a 44.1 kHz
Configuración del modelo:
- Tamaño de FFT: 4096
- Profundidad de la red: 6
Configura el dispositivo de ejecución:
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
model.to(device)

sample_rate = bundle.sample_rate

print(f"Sample rate: {sample_rate}")
4. Construcción de la pipeline de separación de audio
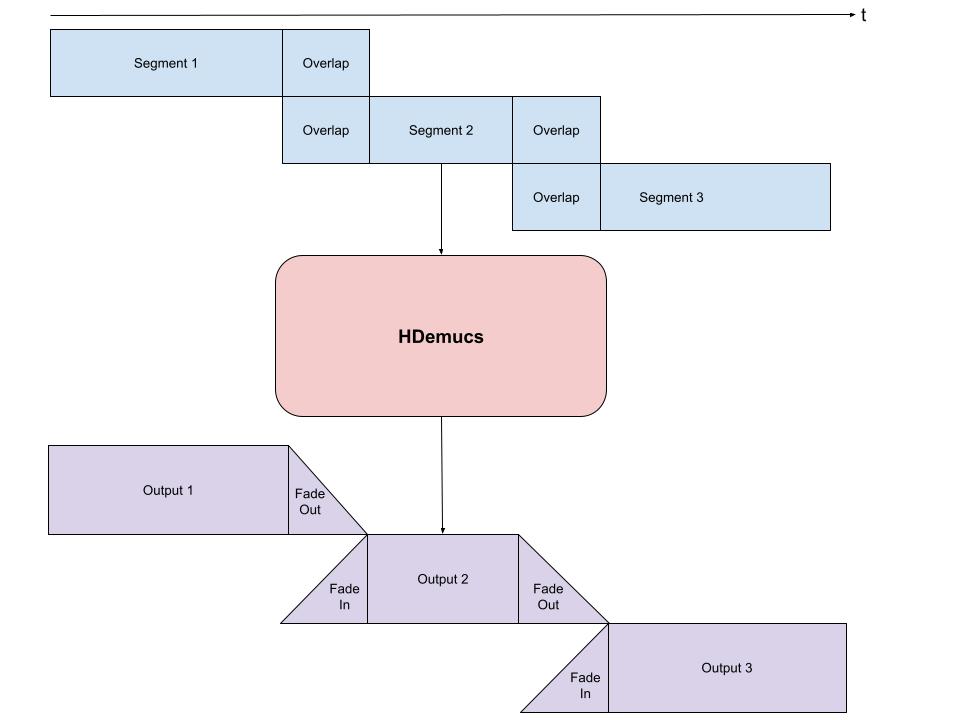
Debido a que HDemucs es intensivo en cómputo y exigente en memoria, realizar la inferencia sobre una canción completa en una sola pasada suele ser poco práctico.
En despliegues reales, el audio largo se procesa típicamente con:
- Segmentación por fragmentos
- Ventanas superpuestas
- Suavizado con fade-in / fade-out
Esta estrategia es necesaria porque:
- Los modelos neuronales tienden a generar artefactos cerca de los límites de los segmentos
- Las regiones superpuestas ayudan a reducir discontinuidades y ruido de frontera
La estrategia de procesamiento se ilustra a continuación:
4.1 Implementación de la función de separación
from torchaudio.transforms import Fade


def separate_sources(
    model,
    mix,
    segment=10.0,
    overlap=0.1,
    device=None,
):
    """
    Perform music source separation using chunked inference.

    Args:
        segment: Length of each audio chunk in seconds
        overlap: Overlap ratio between consecutive chunks
        device: Inference device
    """

    if device is None:
        device = mix.device
    else:
        device = torch.device(device)

    batch, channels, length = mix.shape

    chunk_len = int(sample_rate * segment * (1 + overlap))

    start = 0
    end = chunk_len

    overlap_frames = overlap * sample_rate

    fade = Fade(
        fade_in_len=0,
        fade_out_len=int(overlap_frames),
        fade_shape="linear",
    )

    final = torch.zeros(
        batch,
        len(model.sources),
        channels,
        length,
        device=device,
    )

    while start < length - overlap_frames:

        chunk = mix[:, :, start:end]

        with torch.no_grad():
            out = model.forward(chunk)

        out = fade(out)

        final[:, :, :, start:end] += out

        if start == 0:
            fade.fade_in_len = int(overlap_frames)
            start += int(chunk_len - overlap_frames)
        else:
            start += chunk_len

        end += chunk_len

        if end >= length:
            fade.fade_out_len = 0

    return final
5. Visualización del espectrograma
Define una función auxiliar para la visualización del espectrograma:
def plot_spectrogram(stft, title="Spectrogram"):
    magnitude = stft.abs()

    spectrogram = 20 * torch.log10(
        magnitude + 1e-8
    ).numpy()

    _, axis = plt.subplots(1, 1)

    axis.imshow(
        spectrogram,
        cmap="viridis",
        vmin=-60,
        vmax=0,
        origin="lower",
        aspect="auto",
    )

    axis.set_title(title)

    plt.tight_layout()
6. Ejecución de la separación de fuentes
Usa el audio de demostración oficial de Torchaudio:
SAMPLE_SONG = _download_asset(
    "tutorial-assets/hdemucs_mix.wav"
)

waveform, sample_rate = torchaudio.load(SAMPLE_SONG)

waveform = waveform.to(device)

mixture = waveform
Configura los parámetros de inferencia:
segment = 10
overlap = 0.1
Normaliza la forma de onda:
ref = waveform.mean(0)

waveform = (
    waveform - ref.mean()
) / ref.std()
Ejecuta la separación de fuentes:
sources = separate_sources(
    model,
    waveform[None],
    device=device,
    segment=segment,
    overlap=overlap,
)[0]

sources = sources * ref.std() + ref.mean()
Almacena los stems separados:
sources_list = model.sources

sources = list(sources)

audios = dict(zip(sources_list, sources))
7. Salidas del modelo
El modelo Hybrid Demucs por defecto produce cuatro stems:
| Stem | Descripción |
|---|---|
| drums | Percusión y pistas de batería |
| bass | Instrumentos de bajo |
| vocals | Voces principales y de apoyo |
| other | Acompañamiento restante |
8. Análisis del espectrograma
Configura los parámetros de STFT:
N_FFT = 4096
N_HOP = 4

stft = torchaudio.transforms.Spectrogram(
    n_fft=N_FFT,
    hop_length=N_HOP,
    power=None,
)
9. Extracción del segmento de audio
Extrae el segmento entre 150 s y 155 s:
segment_start = 150
segment_end = 155

frame_start = segment_start * sample_rate
frame_end = segment_end * sample_rate
Carga los stems de referencia correspondientes:
drums_original = _download_asset(
    "tutorial-assets/hdemucs_drums_segment.wav"
)

bass_original = _download_asset(
    "tutorial-assets/hdemucs_bass_segment.wav"
)

vocals_original = _download_asset(
    "tutorial-assets/hdemucs_vocals_segment.wav"
)

other_original = _download_asset(
    "tutorial-assets/hdemucs_other_segment.wav"
)
Extrae los segmentos predichos:
drums_spec = audios["drums"][:, frame_start:frame_end].cpu()
bass_spec = audios["bass"][:, frame_start:frame_end].cpu()
vocals_spec = audios["vocals"][:, frame_start:frame_end].cpu()
other_spec = audios["other"][:, frame_start:frame_end].cpu()

mix_spec = mixture[:, frame_start:frame_end].cpu()
10. Renderizado de espectrogramas y audio
Define una función de utilidad para visualización y reproducción:
def output_results(
    original_source: torch.Tensor,
    predicted_source: torch.Tensor,
    source: str,
):

    plot_spectrogram(
        stft(predicted_source)[0],
        f"Spectrogram - {source}"
    )

    return Audio(
        predicted_source,
        rate=sample_rate
    )
11. Espectrograma de la mezcla
plot_spectrogram(
    stft(mix_spec)[0],
    "Spectrogram - Mixture"
)

Audio(mix_spec, rate=sample_rate)
12. Resultados de la separación de batería
output_results(
    drums,
    drums_spec,
    "drums"
)
13. Resultados de la separación de bajo
output_results(
    bass,
    bass_spec,
    "bass"
)
14. Resultados de la separación vocal
output_results(
    vocals,
    vocals_spec,
    "vocals"
)
15. Resultados del acompañamiento restante
output_results(
    other,
    other_spec,
    "other"
)
16. Reproducción del audio completo
Para escuchar los stems separados completos, descomenta el siguiente código:
# Original mixture
# Audio(mixture, rate=sample_rate)

# Drums
# Audio(audios["drums"], rate=sample_rate)

# Bass
# Audio(audios["bass"], rate=sample_rate)

# Vocals
# Audio(audios["vocals"], rate=sample_rate)

# Other accompaniment
# Audio(audios["other"], rate=sample_rate)
17. Conclusión
Hybrid Demucs integra:
- Modelado convolucional en el dominio del tiempo
- Aprendizaje de espectrogramas en el dominio de la frecuencia
Comparado con los enfoques tradicionales de separación de fuentes, ofrece:
- Mayor fidelidad de separación
- Aislamiento vocal más limpio
- Menor filtración del acompañamiento
Este tutorial adopta además estrategias prácticas de ingeniería que incluyen:
- Inferencia por fragmentos
- Reconstrucción con solapamiento
- Suavizado con fades
Estas técnicas abordan eficazmente los desafíos de la inferencia en audio largo y son muy adecuadas para escenarios de despliegue reales.
Aplicaciones típicas incluyen:
- Conversión de voz cantada con IA
- Extracción vocal
- Generación de karaoke
- Remix de música
- Arreglos automáticos
- Posproducción de audio
Referencias
Las siguientes referencias cubren Hybrid Demucs, la separación de fuentes musicales y el procesamiento de audio basado en deep learning.
1. Hybrid Demucs
[1] Hybrid Spectrogram and Waveform Source Separation
Autor: Alexandre Défossez
Evento: ISMIR 2021 Workshop
Año: 2021
Défossez, A. (2021).
Hybrid Spectrogram and Waveform Source Separation.
arXiv preprint arXiv:2111.03600.
Paper:
https://arxiv.org/abs/2111.03600
Este trabajo introdujo la arquitectura Hybrid Demucs, que combina:
- Convolución en el dominio de la forma de onda
- Aprendizaje de representaciones en el dominio del espectrograma
Sigue siendo una de las arquitecturas más influyentes en la separación de fuentes musicales moderna.
[2] Music Source Separation in the Waveform Domain
Autores: Alexandre Défossez, Nicolas Usunier, Léon Bottou, Francis Bach
Conferencia: ISMIR 2019
Año: 2019
Défossez, A., Usunier, N., Bottou, L., & Bach, F. (2019).
Music Source Separation in the Waveform Domain.
Proceedings of the 20th International Society for Music Information Retrieval Conference (ISMIR).
Paper:
https://arxiv.org/abs/1911.13254
Este paper introdujo la arquitectura Demucs original y pionerizó la separación de fuentes musicales end-to-end basada en formas de onda.
2. Referencias de datasets
[3] The MUSDB18 Corpus for Music Separation
Autores: Zafar Rafii et al.
Dataset: MUSDB18-HQ
Año: 2017
Rafii, Z., Liutkus, A., Stöter, F.-R., Mimilakis, S. I.,
Bittner, R., & Pardo, B. (2017).
The MUSDB18 Corpus for Music Separation.
Dataset:
https://zenodo.org/record/3338373
MUSDB18-HQ es uno de los datasets de referencia más adoptados en la investigación de separación de fuentes musicales.
3. Documentación de PyTorch / Torchaudio
[4] Documentación oficial de Torchaudio
PyTorch Audio Team.
Torchaudio Documentation.
Documentación:
https://pytorch.org/audio/stable/index.html
[5] Tutorial oficial de Hybrid Demucs
PyTorch Audio Team.
Music Source Separation with Hybrid Demucs.
Tutorial:
https://docs.pytorch.org/audio/stable/tutorials/hybrid_demucs_tutorial.html
La estructura de implementación y el flujo experimental de este artículo están parcialmente inspirados en el tutorial oficial.
4. Investigación clásica en separación de fuentes musicales
[6] Open-Unmix — A Reference Implementation for Music Source Separation
Autores: Fabian-Robert Stöter et al.
Journal: Journal of Open Source Software
Año: 2019
Stöter, F.-R., Liutkus, A., & Ito, N. (2019).
The 2018 Signal Separation Evaluation Campaign.
Journal of Open Source Software.
Proyecto:
https://sigsep.github.io/open-unmix/
[7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
Autores: Andreas Jansson et al.
Conferencia: ISMIR 2017
Jansson, A., Humphrey, E., Montecchio, N.,
Bittner, R., Kumar, A., & Weyde, T. (2017).
Singing Voice Separation with Deep U-Net Convolutional Networks.
Paper:
https://ismir2017.smcnus.org/wp-content/uploads/2017/10/171_Paper.pdf
5. Métricas de evaluación
[8] BSS Eval Metrics
Vincent, E., Gribonval, R., & Févotte, C. (2006).
Performance Measurement in Blind Audio Source Separation.
IEEE Transactions on Audio, Speech, and Language Processing.
Paper:
https://ieeexplore.ieee.org/document/1643671
Este trabajo introdujo varias métricas clásicas de evaluación para la separación de fuentes, incluyendo:
- SDR (Signal-to-Distortion Ratio)
- SIR (Signal-to-Interference Ratio)
- SAR (Signal-to-Artifacts Ratio)
6. Deep learning para el procesamiento de audio
[9] Deep Learning for Audio Signal Processing
Kellman, M., et al.
Deep Learning for Audio Signal Processing.
Editorial:
Cambridge University Press
[10] Fundamentals of Music Processing
Müller, M. (2015).
Fundamentals of Music Processing.
Springer.
Web del libro:
https://www.music-processing.de/
7. Recursos recomendados para profundizar
| Tema | Recurso |
|---|---|
| Repositorio oficial de Demucs | https://github.com/facebookresearch/demucs |
| PyTorch Audio | https://pytorch.org/audio/stable/index.html |
| Comunidad de separación de fuentes | https://sigsep.github.io/ |
| Dataset MUSDB | https://zenodo.org/record/3338373 |
| Sociedad ISMIR | https://ismir.net/ |