Séparation de sources musicales avec l'IA
Tutoriel pratique de séparation de sources musicales par IA avec Hybrid Demucs : séparez les morceaux en voix, batterie, basse et autres stems, avec code complet, spectrogrammes et résultats.
Sur cette page
- 1. Introduction
- 2. Configuration de l'environnement
- 3. Chargement du modèle Hybrid Demucs
- 4. Construction de la pipeline de séparation audio
- 4.1 Implémentation de la fonction de séparation
- 5. Visualisation du spectrogramme
- 6. Exécution de la séparation de sources
- 7. Sorties du modèle
- 8. Analyse du spectrogramme
- 9. Extraction du segment audio
- 10. Rendu des spectrogrammes et de l'audio
- 11. Spectrogramme du mixage
- 12. Résultats de la séparation de batterie
- 13. Résultats de la séparation de basse
- 14. Résultats de la séparation vocale
- 15. Résultats de l'accompagnement restant
- 16. Lecture de l'audio complet
- 17. Conclusion
- Références
- 1. Hybrid Demucs
- [1] Hybrid Spectrogram and Waveform Source Separation
- [2] Music Source Separation in the Waveform Domain
- 2. Références de jeux de données
- [3] The MUSDB18 Corpus for Music Separation
- 3. Documentation PyTorch / Torchaudio
- [4] Documentation officielle de Torchaudio
- [5] Tutoriel officiel Hybrid Demucs
- 4. Recherche classique en séparation de sources musicales
- [6] Open-Unmix — A Reference Implementation for Music Source Separation
- [7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
- 5. Métriques d'évaluation
- [8] BSS Eval Metrics
- 6. Deep learning pour le traitement audio
- [9] Deep Learning for Audio Signal Processing
- [10] Fundamentals of Music Processing
- 7. Ressources recommandées pour aller plus loin
Référence auteur : Sean Kim
Référence modèle : Hybrid Demucs (Défossez, 2021)
1. Introduction
Ce tutoriel montre comment réaliser une séparation de sources musicales avec le modèle Hybrid Demucs. L'objectif est de décomposer une piste musicale mixée en ses stems constitutifs, notamment :
- Voix
- Batterie
- Basse
- Autres composants d'accompagnement
Le flux de travail complet se compose des étapes suivantes :
- Initialisation du modèle de séparation Hybrid Demucs
- Découpage de l'audio long en chunks chevauchants
- Inférence du modèle chunk par chunk
- Reconstruction de l'audio complet à partir de tous les segments
- Export des stems séparés et visualisation des spectrogrammes
Hybrid Demucs est une version améliorée de l'architecture Demucs d'origine.
Elle combine :
- La modélisation convolutive dans le domaine de la forme d'onde
- L'apprentissage de caractéristiques dans le domaine du spectrogramme
En exploitant conjointement les représentations temporelles et fréquentielles, Hybrid Demucs obtient une séparation de sources nettement plus naturelle et fidèle que les approches conventionnelles.
Ressources associées :
- Paper Hybrid Demucs : https://arxiv.org/abs/2111.03600
- Dépôt officiel : https://github.com/facebookresearch/demucs
2. Configuration de l'environnement
Installez les dépendances nécessaires :
pip install torch torchaudio matplotlibImportez les modules nécessaires :
import torch
import torchaudio
import matplotlib.pyplot as plt

from IPython.display import Audio
from torchaudio.pipelines import HDEMUCS_HIGH_MUSDB_PLUS
from torchaudio.utils import _download_asset
Vérifiez les versions installées :
print(torch.__version__)
print(torchaudio.__version__)
3. Chargement du modèle Hybrid Demucs
Torchaudio fournit une pipeline Hybrid Demucs pré-entraînée prête à l'emploi :
bundle = HDEMUCS_HIGH_MUSDB_PLUS
model = bundle.get_model()
Le modèle sélectionné :
- Est entraîné sur le jeu de données MUSDB18-HQ
- Inclut des données d'augmentation propriétaires supplémentaires
- Est optimisé pour le traitement audio haute qualité à 44,1 kHz
Configuration du modèle :
- Taille FFT : 4096
- Profondeur du réseau : 6
Configurez le périphérique d'exécution :
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
model.to(device)

sample_rate = bundle.sample_rate

print(f"Sample rate: {sample_rate}")
4. Construction de la pipeline de séparation audio
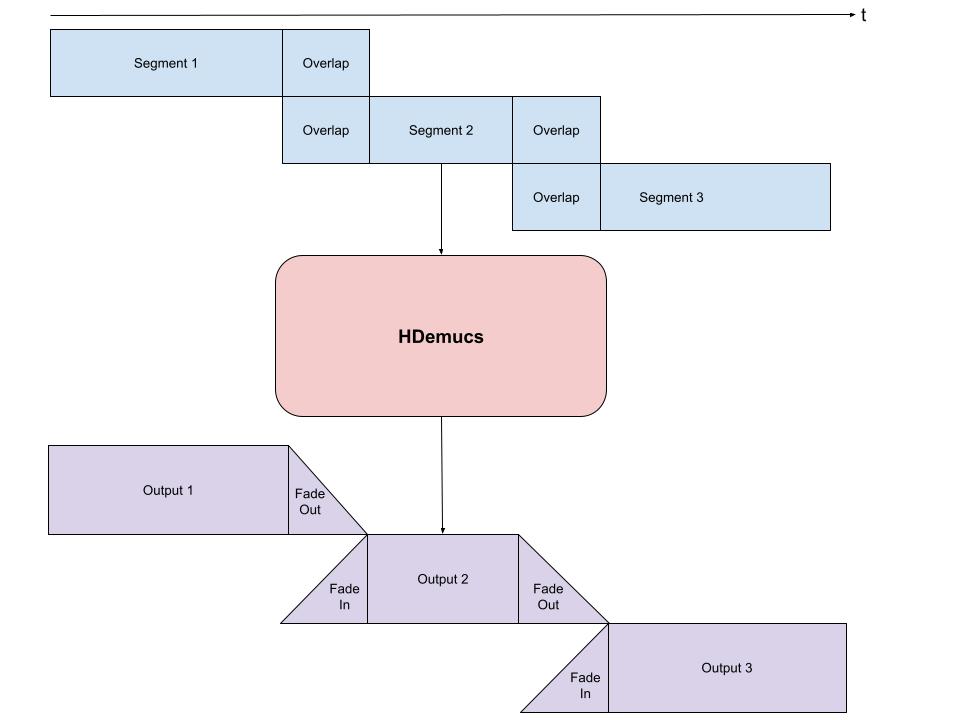
HDemucs étant gourmand en calcul et en mémoire, effectuer l'inférence sur une chanson entière en une seule passe est souvent peu pratique.
Dans les déploiements réels, l'audio long est généralement traité avec :
- Une segmentation par chunks
- Des fenêtres chevauchantes
- Un lissage fondu entrant / sortant
Cette stratégie est nécessaire car :
- Les modèles neuronaux ont tendance à générer des artefacts près des frontières de segments
- Les zones de chevauchement aident à réduire les discontinuités et le bruit de frontière
La stratégie de traitement est illustrée ci-dessous :
4.1 Implémentation de la fonction de séparation
from torchaudio.transforms import Fade


def separate_sources(
    model,
    mix,
    segment=10.0,
    overlap=0.1,
    device=None,
):
    """
    Perform music source separation using chunked inference.

    Args:
        segment: Length of each audio chunk in seconds
        overlap: Overlap ratio between consecutive chunks
        device: Inference device
    """

    if device is None:
        device = mix.device
    else:
        device = torch.device(device)

    batch, channels, length = mix.shape

    chunk_len = int(sample_rate * segment * (1 + overlap))

    start = 0
    end = chunk_len

    overlap_frames = overlap * sample_rate

    fade = Fade(
        fade_in_len=0,
        fade_out_len=int(overlap_frames),
        fade_shape="linear",
    )

    final = torch.zeros(
        batch,
        len(model.sources),
        channels,
        length,
        device=device,
    )

    while start < length - overlap_frames:

        chunk = mix[:, :, start:end]

        with torch.no_grad():
            out = model.forward(chunk)

        out = fade(out)

        final[:, :, :, start:end] += out

        if start == 0:
            fade.fade_in_len = int(overlap_frames)
            start += int(chunk_len - overlap_frames)
        else:
            start += chunk_len

        end += chunk_len

        if end >= length:
            fade.fade_out_len = 0

    return final
5. Visualisation du spectrogramme
Définissez une fonction utilitaire pour la visualisation du spectrogramme :
def plot_spectrogram(stft, title="Spectrogram"):
    magnitude = stft.abs()

    spectrogram = 20 * torch.log10(
        magnitude + 1e-8
    ).numpy()

    _, axis = plt.subplots(1, 1)

    axis.imshow(
        spectrogram,
        cmap="viridis",
        vmin=-60,
        vmax=0,
        origin="lower",
        aspect="auto",
    )

    axis.set_title(title)

    plt.tight_layout()
6. Exécution de la séparation de sources
Utilisez l'audio de démonstration officiel fourni par Torchaudio :
SAMPLE_SONG = _download_asset(
    "tutorial-assets/hdemucs_mix.wav"
)

waveform, sample_rate = torchaudio.load(SAMPLE_SONG)

waveform = waveform.to(device)

mixture = waveform
Configurez les paramètres d'inférence :
segment = 10
overlap = 0.1
Normalisez la forme d'onde :
ref = waveform.mean(0)

waveform = (
    waveform - ref.mean()
) / ref.std()
Lancez la séparation de sources :
sources = separate_sources(
    model,
    waveform[None],
    device=device,
    segment=segment,
    overlap=overlap,
)[0]

sources = sources * ref.std() + ref.mean()
Stockez les stems séparés :
sources_list = model.sources

sources = list(sources)

audios = dict(zip(sources_list, sources))
7. Sorties du modèle
Le modèle Hybrid Demucs par défaut produit quatre stems :
| Stem | Description |
|---|---|
| drums | Percussions et pistes de batterie |
| bass | Instruments de basse |
| vocals | Voix lead et chœurs |
| other | Accompagnement restant |
8. Analyse du spectrogramme
Configurez les paramètres STFT :
N_FFT = 4096
N_HOP = 4

stft = torchaudio.transforms.Spectrogram(
    n_fft=N_FFT,
    hop_length=N_HOP,
    power=None,
)
9. Extraction du segment audio
Extrayez le segment entre 150 s et 155 s :
segment_start = 150
segment_end = 155

frame_start = segment_start * sample_rate
frame_end = segment_end * sample_rate
Chargez les stems de référence correspondants :
drums_original = _download_asset(
    "tutorial-assets/hdemucs_drums_segment.wav"
)

bass_original = _download_asset(
    "tutorial-assets/hdemucs_bass_segment.wav"
)

vocals_original = _download_asset(
    "tutorial-assets/hdemucs_vocals_segment.wav"
)

other_original = _download_asset(
    "tutorial-assets/hdemucs_other_segment.wav"
)
Extrayez les segments prédits :
drums_spec = audios["drums"][:, frame_start:frame_end].cpu()
bass_spec = audios["bass"][:, frame_start:frame_end].cpu()
vocals_spec = audios["vocals"][:, frame_start:frame_end].cpu()
other_spec = audios["other"][:, frame_start:frame_end].cpu()

mix_spec = mixture[:, frame_start:frame_end].cpu()
10. Rendu des spectrogrammes et de l'audio
Définissez une fonction utilitaire pour la visualisation et la lecture :
def output_results(
    original_source: torch.Tensor,
    predicted_source: torch.Tensor,
    source: str,
):

    plot_spectrogram(
        stft(predicted_source)[0],
        f"Spectrogram - {source}"
    )

    return Audio(
        predicted_source,
        rate=sample_rate
    )
11. Spectrogramme du mixage
plot_spectrogram(
    stft(mix_spec)[0],
    "Spectrogram - Mixture"
)

Audio(mix_spec, rate=sample_rate)
12. Résultats de la séparation de batterie
output_results(
    drums,
    drums_spec,
    "drums"
)
13. Résultats de la séparation de basse
output_results(
    bass,
    bass_spec,
    "bass"
)
14. Résultats de la séparation vocale
output_results(
    vocals,
    vocals_spec,
    "vocals"
)
15. Résultats de l'accompagnement restant
output_results(
    other,
    other_spec,
    "other"
)
16. Lecture de l'audio complet
Pour écouter les stems séparés dans leur intégralité, décommentez le code suivant :
# Original mixture
# Audio(mixture, rate=sample_rate)

# Drums
# Audio(audios["drums"], rate=sample_rate)

# Bass
# Audio(audios["bass"], rate=sample_rate)

# Vocals
# Audio(audios["vocals"], rate=sample_rate)

# Other accompaniment
# Audio(audios["other"], rate=sample_rate)
17. Conclusion
Hybrid Demucs intègre :
- La modélisation convolutive dans le domaine temporel
- L'apprentissage de spectrogrammes dans le domaine fréquentiel
Comparé aux approches traditionnelles de séparation de sources, il offre :
- Une plus grande fidélité de séparation
- Une isolation vocale plus propre
- Moins de fuite de l'accompagnement
Ce tutoriel adopte en outre des stratégies d'ingénierie pratiques incluant :
- L'inférence par chunks
- La reconstruction avec chevauchement
- Le lissage par fondu
Ces techniques répondent efficacement aux défis de l'inférence sur les audios longs et conviennent parfaitement aux scénarios de déploiement réels.
Applications typiques :
- Conversion de voix chantée par IA
- Extraction vocale
- Génération de karaoké
- Remix musical
- Arrangement automatique
- Post-traitement audio
Références
Les références suivantes couvrent Hybrid Demucs, la séparation de sources musicales et le traitement audio par apprentissage profond.
1. Hybrid Demucs
[1] Hybrid Spectrogram and Waveform Source Separation
Auteur : Alexandre Défossez
Lieu : ISMIR 2021 Workshop
Année : 2021
Défossez, A. (2021).
Hybrid Spectrogram and Waveform Source Separation.
arXiv preprint arXiv:2111.03600.
Paper :
https://arxiv.org/abs/2111.03600
Ce travail a introduit l'architecture Hybrid Demucs, qui combine :
- La convolution dans le domaine de la forme d'onde
- L'apprentissage de représentations dans le domaine du spectrogramme
Elle demeure l'une des architectures les plus influentes de la séparation de sources musicales moderne.
[2] Music Source Separation in the Waveform Domain
Auteurs : Alexandre Défossez, Nicolas Usunier, Léon Bottou, Francis Bach
Conférence : ISMIR 2019
Année : 2019
Défossez, A., Usunier, N., Bottou, L., & Bach, F. (2019).
Music Source Separation in the Waveform Domain.
Proceedings of the 20th International Society for Music Information Retrieval Conference (ISMIR).
Paper :
https://arxiv.org/abs/1911.13254
Ce paper a introduit l'architecture Demucs d'origine et a été pionnier de la séparation de sources musicales end-to-end basée sur les formes d'onde.
2. Références de jeux de données
[3] The MUSDB18 Corpus for Music Separation
Auteurs : Zafar Rafii et al.
Dataset : MUSDB18-HQ
Année : 2017
Rafii, Z., Liutkus, A., Stöter, F.-R., Mimilakis, S. I.,
Bittner, R., & Pardo, B. (2017).
The MUSDB18 Corpus for Music Separation.
Dataset :
https://zenodo.org/record/3338373
MUSDB18-HQ est l'un des jeux de données de référence les plus utilisés dans la recherche en séparation de sources musicales.
3. Documentation PyTorch / Torchaudio
[4] Documentation officielle de Torchaudio
PyTorch Audio Team.
Torchaudio Documentation.
Documentation :
https://pytorch.org/audio/stable/index.html
[5] Tutoriel officiel Hybrid Demucs
PyTorch Audio Team.
Music Source Separation with Hybrid Demucs.
Tutoriel :
https://docs.pytorch.org/audio/stable/tutorials/hybrid_demucs_tutorial.html
La structure d'implémentation et le flux expérimental présentés dans cet article sont partiellement inspirés du tutoriel officiel.
4. Recherche classique en séparation de sources musicales
[6] Open-Unmix — A Reference Implementation for Music Source Separation
Auteurs : Fabian-Robert Stöter et al.
Journal : Journal of Open Source Software
Année : 2019
Stöter, F.-R., Liutkus, A., & Ito, N. (2019).
The 2018 Signal Separation Evaluation Campaign.
Journal of Open Source Software.
Projet :
https://sigsep.github.io/open-unmix/
[7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
Auteurs : Andreas Jansson et al.
Conférence : ISMIR 2017
Jansson, A., Humphrey, E., Montecchio, N.,
Bittner, R., Kumar, A., & Weyde, T. (2017).
Singing Voice Separation with Deep U-Net Convolutional Networks.
Paper :
https://ismir2017.smcnus.org/wp-content/uploads/2017/10/171_Paper.pdf
5. Métriques d'évaluation
[8] BSS Eval Metrics
Vincent, E., Gribonval, R., & Févotte, C. (2006).
Performance Measurement in Blind Audio Source Separation.
IEEE Transactions on Audio, Speech, and Language Processing.
Paper :
https://ieeexplore.ieee.org/document/1643671
Ce travail a introduit plusieurs métriques d'évaluation classiques pour la séparation de sources, notamment :
- SDR (Signal-to-Distortion Ratio)
- SIR (Signal-to-Interference Ratio)
- SAR (Signal-to-Artifacts Ratio)
6. Deep learning pour le traitement audio
[9] Deep Learning for Audio Signal Processing
Kellman, M., et al.
Deep Learning for Audio Signal Processing.
Éditeur :
Cambridge University Press
[10] Fundamentals of Music Processing
Müller, M. (2015).
Fundamentals of Music Processing.
Springer.
Site du livre :
https://www.music-processing.de/
7. Ressources recommandées pour aller plus loin
| Sujet | Ressource |
|---|---|
| Dépôt officiel Demucs | https://github.com/facebookresearch/demucs |
| PyTorch Audio | https://pytorch.org/audio/stable/index.html |
| Communauté de séparation de sources | https://sigsep.github.io/ |
| Dataset MUSDB | https://zenodo.org/record/3338373 |
| Société ISMIR | https://ismir.net/ |