Separazione delle sorgenti musicali con l'IA
Guida pratica alla separazione delle sorgenti musicali con IA tramite Hybrid Demucs: dividi i brani in voce, batteria, basso e altri stems, con codice completo, spettrogrammi e risultati.
In questa pagina
- 1. Introduzione
- 2. Configurazione dell'ambiente
- 3. Caricamento del modello Hybrid Demucs
- 4. Costruzione della pipeline di separazione audio
- 4.1 Implementazione della funzione di separazione
- 5. Visualizzazione dello spettrogramma
- 6. Esecuzione della separazione delle sorgenti
- 7. Output del modello
- 8. Analisi dello spettrogramma
- 9. Estrazione del segmento audio
- 10. Rendering di spettrogrammi e audio
- 11. Spettrogramma del mix
- 12. Risultati della separazione della batteria
- 13. Risultati della separazione del basso
- 14. Risultati della separazione vocale
- 15. Risultati dell'accompagnamento restante
- 16. Riproduzione dell'audio completo
- 17. Conclusione
- Riferimenti
- 1. Hybrid Demucs
- [1] Hybrid Spectrogram and Waveform Source Separation
- [2] Music Source Separation in the Waveform Domain
- 2. Riferimenti ai dataset
- [3] The MUSDB18 Corpus for Music Separation
- 3. Documentazione PyTorch / Torchaudio
- [4] Documentazione ufficiale di Torchaudio
- [5] Tutorial ufficiale Hybrid Demucs
- 4. Ricerca classica sulla separazione delle sorgenti musicali
- [6] Open-Unmix — A Reference Implementation for Music Source Separation
- [7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
- 5. Metriche di valutazione
- [8] BSS Eval Metrics
- 6. Deep learning per l'elaborazione audio
- [9] Deep Learning for Audio Signal Processing
- [10] Fundamentals of Music Processing
- 7. Risorse consigliate per approfondire
Riferimento autore: Sean Kim
Riferimento modello: Hybrid Demucs (Défossez, 2021)
1. Introduzione
Questo tutorial mostra come eseguire la separazione delle sorgenti musicali utilizzando il modello Hybrid Demucs. L'obiettivo è scomporre una traccia musicale miscelata nei suoi stem costitutivi, tra cui:
- Voce
- Batteria
- Basso
- Altri componenti di accompagnamento
Il flusso di lavoro completo consiste nelle seguenti fasi:
- Inizializzazione del modello di separazione Hybrid Demucs
- Suddivisione dell'audio lungo in chunk sovrapposti
- Inferenza del modello chunk per chunk
- Ricostruzione dell'audio completo da tutti i segmenti
- Esportazione degli stem separati e visualizzazione degli spettrogrammi
Hybrid Demucs è una versione potenziata dell'architettura Demucs originale.
Combina:
- Modellazione convoluzionale nel dominio della forma d'onda
- Apprendimento di caratteristiche nel dominio dello spettrogramma
Sfruttando congiuntamente le rappresentazioni nel dominio del tempo e della frequenza, Hybrid Demucs ottiene una separazione delle sorgenti notevolmente più naturale e fedele rispetto agli approcci convenzionali.
Risorse correlate:
- Paper Hybrid Demucs: https://arxiv.org/abs/2111.03600
- Repository ufficiale: https://github.com/facebookresearch/demucs
2. Configurazione dell'ambiente
Installa le dipendenze necessarie:
pip install torch torchaudio matplotlibImporta i moduli necessari:
import torch
import torchaudio
import matplotlib.pyplot as plt

from IPython.display import Audio
from torchaudio.pipelines import HDEMUCS_HIGH_MUSDB_PLUS
from torchaudio.utils import _download_asset
Verifica le versioni installate:
print(torch.__version__)
print(torchaudio.__version__)
3. Caricamento del modello Hybrid Demucs
Torchaudio fornisce una pipeline Hybrid Demucs pre-addestrata pronta all'uso:
bundle = HDEMUCS_HIGH_MUSDB_PLUS
model = bundle.get_model()
Il modello selezionato:
- È addestrato sul dataset MUSDB18-HQ
- Include dati di augmentation proprietari aggiuntivi
- È ottimizzato per l'elaborazione audio ad alta qualità a 44,1 kHz
Configurazione del modello:
- Dimensione FFT: 4096
- Profondità della rete: 6
Configura il dispositivo di esecuzione:
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
model.to(device)

sample_rate = bundle.sample_rate

print(f"Sample rate: {sample_rate}")
4. Costruzione della pipeline di separazione audio
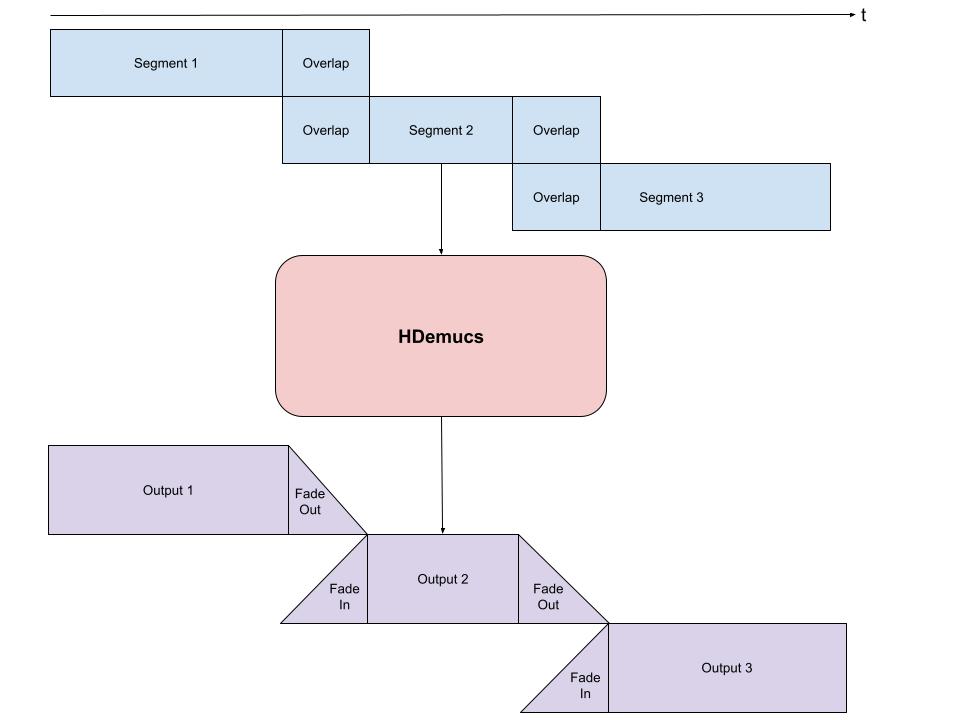
Poiché HDemucs è intensivo in termini di calcolo e memoria, eseguire l'inferenza su un'intera canzone in un'unica passata è spesso poco pratico.
Nei deployment reali, l'audio lungo viene tipicamente elaborato con:
- Segmentazione a chunk
- Finestre sovrapposte
- Smussi fade-in / fade-out
Questa strategia è necessaria perché:
- I modelli neurali tendono a generare artefatti vicino ai confini dei segmenti
- Le regioni sovrapposte aiutano a ridurre le discontinuità e il rumore di confine
La strategia di elaborazione è illustrata di seguito:
4.1 Implementazione della funzione di separazione
from torchaudio.transforms import Fade


def separate_sources(
    model,
    mix,
    segment=10.0,
    overlap=0.1,
    device=None,
):
    """
    Perform music source separation using chunked inference.

    Args:
        segment: Length of each audio chunk in seconds
        overlap: Overlap ratio between consecutive chunks
        device: Inference device
    """

    if device is None:
        device = mix.device
    else:
        device = torch.device(device)

    batch, channels, length = mix.shape

    chunk_len = int(sample_rate * segment * (1 + overlap))

    start = 0
    end = chunk_len

    overlap_frames = overlap * sample_rate

    fade = Fade(
        fade_in_len=0,
        fade_out_len=int(overlap_frames),
        fade_shape="linear",
    )

    final = torch.zeros(
        batch,
        len(model.sources),
        channels,
        length,
        device=device,
    )

    while start < length - overlap_frames:

        chunk = mix[:, :, start:end]

        with torch.no_grad():
            out = model.forward(chunk)

        out = fade(out)

        final[:, :, :, start:end] += out

        if start == 0:
            fade.fade_in_len = int(overlap_frames)
            start += int(chunk_len - overlap_frames)
        else:
            start += chunk_len

        end += chunk_len

        if end >= length:
            fade.fade_out_len = 0

    return final
5. Visualizzazione dello spettrogramma
Definisci una funzione di supporto per la visualizzazione dello spettrogramma:
def plot_spectrogram(stft, title="Spectrogram"):
    magnitude = stft.abs()

    spectrogram = 20 * torch.log10(
        magnitude + 1e-8
    ).numpy()

    _, axis = plt.subplots(1, 1)

    axis.imshow(
        spectrogram,
        cmap="viridis",
        vmin=-60,
        vmax=0,
        origin="lower",
        aspect="auto",
    )

    axis.set_title(title)

    plt.tight_layout()
6. Esecuzione della separazione delle sorgenti
Usa l'audio dimostrativo ufficiale fornito da Torchaudio:
SAMPLE_SONG = _download_asset(
    "tutorial-assets/hdemucs_mix.wav"
)

waveform, sample_rate = torchaudio.load(SAMPLE_SONG)

waveform = waveform.to(device)

mixture = waveform
Configura i parametri di inferenza:
segment = 10
overlap = 0.1
Normalizza la forma d'onda:
ref = waveform.mean(0)

waveform = (
    waveform - ref.mean()
) / ref.std()
Esegui la separazione delle sorgenti:
sources = separate_sources(
    model,
    waveform[None],
    device=device,
    segment=segment,
    overlap=overlap,
)[0]

sources = sources * ref.std() + ref.mean()
Memorizza gli stem separati:
sources_list = model.sources

sources = list(sources)

audios = dict(zip(sources_list, sources))
7. Output del modello
Il modello Hybrid Demucs predefinito produce quattro stem:
| Stem | Descrizione |
|---|---|
| drums | Percussioni e tracce di batteria |
| bass | Strumenti bassi |
| vocals | Voci principali e di supporto |
| other | Accompagnamento rimanente |
8. Analisi dello spettrogramma
Configura i parametri STFT:
N_FFT = 4096
N_HOP = 4

stft = torchaudio.transforms.Spectrogram(
    n_fft=N_FFT,
    hop_length=N_HOP,
    power=None,
)
9. Estrazione del segmento audio
Estrai il segmento tra 150 s e 155 s:
segment_start = 150
segment_end = 155

frame_start = segment_start * sample_rate
frame_end = segment_end * sample_rate
Carica gli stem di riferimento corrispondenti:
drums_original = _download_asset(
    "tutorial-assets/hdemucs_drums_segment.wav"
)

bass_original = _download_asset(
    "tutorial-assets/hdemucs_bass_segment.wav"
)

vocals_original = _download_asset(
    "tutorial-assets/hdemucs_vocals_segment.wav"
)

other_original = _download_asset(
    "tutorial-assets/hdemucs_other_segment.wav"
)
Estrai i segmenti previsti:
drums_spec = audios["drums"][:, frame_start:frame_end].cpu()
bass_spec = audios["bass"][:, frame_start:frame_end].cpu()
vocals_spec = audios["vocals"][:, frame_start:frame_end].cpu()
other_spec = audios["other"][:, frame_start:frame_end].cpu()

mix_spec = mixture[:, frame_start:frame_end].cpu()
10. Rendering di spettrogrammi e audio
Definisci una funzione di utilità per visualizzazione e riproduzione:
def output_results(
    original_source: torch.Tensor,
    predicted_source: torch.Tensor,
    source: str,
):

    plot_spectrogram(
        stft(predicted_source)[0],
        f"Spectrogram - {source}"
    )

    return Audio(
        predicted_source,
        rate=sample_rate
    )
11. Spettrogramma del mix
plot_spectrogram(
    stft(mix_spec)[0],
    "Spectrogram - Mixture"
)

Audio(mix_spec, rate=sample_rate)
12. Risultati della separazione della batteria
output_results(
    drums,
    drums_spec,
    "drums"
)
13. Risultati della separazione del basso
output_results(
    bass,
    bass_spec,
    "bass"
)
14. Risultati della separazione vocale
output_results(
    vocals,
    vocals_spec,
    "vocals"
)
15. Risultati dell'accompagnamento restante
output_results(
    other,
    other_spec,
    "other"
)
16. Riproduzione dell'audio completo
Per ascoltare gli stem separati completi, decommenta il seguente codice:
# Original mixture
# Audio(mixture, rate=sample_rate)

# Drums
# Audio(audios["drums"], rate=sample_rate)

# Bass
# Audio(audios["bass"], rate=sample_rate)

# Vocals
# Audio(audios["vocals"], rate=sample_rate)

# Other accompaniment
# Audio(audios["other"], rate=sample_rate)
17. Conclusione
Hybrid Demucs integra:
- Modellazione convoluzionale nel dominio del tempo
- Apprendimento di spettrogrammi nel dominio della frequenza
Rispetto agli approcci tradizionali di separazione delle sorgenti, offre:
- Maggiore fedeltà di separazione
- Isolamento vocale più pulito
- Minore perdita dell'accompagnamento
Questo tutorial adotta inoltre strategie pratiche di ingegneria tra cui:
- Inferenza a chunk
- Ricostruzione con sovrapposizione
- Smussi con fade
Queste tecniche affrontano efficacemente le sfide dell'inferenza su audio lunghi e sono altamente adatte a scenari di deployment reali.
Applicazioni tipiche includono:
- Conversione di voci cantate con IA
- Estrazione vocale
- Generazione di karaoke
- Remix musicale
- Arrangiamento automatico
- Post-produzione audio
Riferimenti
I seguenti riferimenti coprono Hybrid Demucs, la separazione delle sorgenti musicali e l'elaborazione audio basata su deep learning.
1. Hybrid Demucs
[1] Hybrid Spectrogram and Waveform Source Separation
Autore: Alexandre Défossez
Sede: ISMIR 2021 Workshop
Anno: 2021
Défossez, A. (2021).
Hybrid Spectrogram and Waveform Source Separation.
arXiv preprint arXiv:2111.03600.
Paper:
https://arxiv.org/abs/2111.03600
Questo lavoro ha introdotto l'architettura Hybrid Demucs, che combina:
- Convoluzione nel dominio della forma d'onda
- Apprendimento di rappresentazioni nel dominio dello spettrogramma
Rimane una delle architetture più influenti nella separazione delle sorgenti musicali moderna.
[2] Music Source Separation in the Waveform Domain
Autori: Alexandre Défossez, Nicolas Usunier, Léon Bottou, Francis Bach
Conferenza: ISMIR 2019
Anno: 2019
Défossez, A., Usunier, N., Bottou, L., & Bach, F. (2019).
Music Source Separation in the Waveform Domain.
Proceedings of the 20th International Society for Music Information Retrieval Conference (ISMIR).
Paper:
https://arxiv.org/abs/1911.13254
Questo paper ha introdotto l'architettura Demucs originale ed è stato pioniere della separazione delle sorgenti musicali end-to-end basata sulla forma d'onda.
2. Riferimenti ai dataset
[3] The MUSDB18 Corpus for Music Separation
Autori: Zafar Rafii et al.
Dataset: MUSDB18-HQ
Anno: 2017
Rafii, Z., Liutkus, A., Stöter, F.-R., Mimilakis, S. I.,
Bittner, R., & Pardo, B. (2017).
The MUSDB18 Corpus for Music Separation.
Dataset:
https://zenodo.org/record/3338373
MUSDB18-HQ è uno dei dataset di benchmark più adottati nella ricerca sulla separazione delle sorgenti musicali.
3. Documentazione PyTorch / Torchaudio
[4] Documentazione ufficiale di Torchaudio
PyTorch Audio Team.
Torchaudio Documentation.
Documentazione:
https://pytorch.org/audio/stable/index.html
[5] Tutorial ufficiale Hybrid Demucs
PyTorch Audio Team.
Music Source Separation with Hybrid Demucs.
Tutorial:
https://docs.pytorch.org/audio/stable/tutorials/hybrid_demucs_tutorial.html
La struttura di implementazione e il flusso sperimentale presentati in questo articolo sono parzialmente ispirati al tutorial ufficiale.
4. Ricerca classica sulla separazione delle sorgenti musicali
[6] Open-Unmix — A Reference Implementation for Music Source Separation
Autori: Fabian-Robert Stöter et al.
Journal: Journal of Open Source Software
Anno: 2019
Stöter, F.-R., Liutkus, A., & Ito, N. (2019).
The 2018 Signal Separation Evaluation Campaign.
Journal of Open Source Software.
Progetto:
https://sigsep.github.io/open-unmix/
[7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
Autori: Andreas Jansson et al.
Conferenza: ISMIR 2017
Jansson, A., Humphrey, E., Montecchio, N.,
Bittner, R., Kumar, A., & Weyde, T. (2017).
Singing Voice Separation with Deep U-Net Convolutional Networks.
Paper:
https://ismir2017.smcnus.org/wp-content/uploads/2017/10/171_Paper.pdf
5. Metriche di valutazione
[8] BSS Eval Metrics
Vincent, E., Gribonval, R., & Févotte, C. (2006).
Performance Measurement in Blind Audio Source Separation.
IEEE Transactions on Audio, Speech, and Language Processing.
Paper:
https://ieeexplore.ieee.org/document/1643671
Questo lavoro ha introdotto diverse metriche classiche di valutazione per la separazione delle sorgenti, tra cui:
- SDR (Signal-to-Distortion Ratio)
- SIR (Signal-to-Interference Ratio)
- SAR (Signal-to-Artifacts Ratio)
6. Deep learning per l'elaborazione audio
[9] Deep Learning for Audio Signal Processing
Kellman, M., et al.
Deep Learning for Audio Signal Processing.
Editore:
Cambridge University Press
[10] Fundamentals of Music Processing
Müller, M. (2015).
Fundamentals of Music Processing.
Springer.
Sito del libro:
https://www.music-processing.de/
7. Risorse consigliate per approfondire
| Argomento | Risorsa |
|---|---|
| Repository ufficiale Demucs | https://github.com/facebookresearch/demucs |
| PyTorch Audio | https://pytorch.org/audio/stable/index.html |
| Comunità di separazione delle sorgenti | https://sigsep.github.io/ |
| Dataset MUSDB | https://zenodo.org/record/3338373 |
| Società ISMIR | https://ismir.net/ |