AI로 하는 음악 소스 분리
Hybrid Demucs로 음악 스템을 분리하는 실전 가이드. 노래를 보컬·드럼·베이스 등 트랙으로 나누는 과정을 코드, 스펙트로그램, 청취 결과와 함께 소개합니다.
목차
- 1. 소개
- 2. 환경 설정
- 3. Hybrid Demucs 모델 로드
- 4. 오디오 분리 파이프라인 구축
- 4.1 분리 함수 구현
- 5. 스펙트로그램 시각화
- 6. 소스 분리 실행
- 7. 모델 출력
- 8. 스펙트로그램 분석
- 9. 오디오 세그먼트 추출
- 10. 스펙트로그램 및 오디오 렌더링
- 11. 믹스 스펙트로그램
- 12. 드럼 분리 결과
- 13. 베이스 분리 결과
- 14. 보컬 분리 결과
- 15. 기타 반주 결과
- 16. 전체 오디오 재생
- 17. 결론
- 참고 자료
- 1. Hybrid Demucs
- [1] Hybrid Spectrogram and Waveform Source Separation
- [2] Music Source Separation in the Waveform Domain
- 2. 데이터셋 참고 자료
- [3] The MUSDB18 Corpus for Music Separation
- 3. PyTorch / Torchaudio 문서
- [4] Torchaudio 공식 문서
- [5] 공식 Hybrid Demucs 튜토리얼
- 4. 음악 소스 분리의 고전 연구
- [6] Open-Unmix — A Reference Implementation for Music Source Separation
- [7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
- 5. 평가 지표
- [8] BSS Eval Metrics
- 6. 오디오 처리를 위한 딥러닝
- [9] Deep Learning for Audio Signal Processing
- [10] Fundamentals of Music Processing
- 7. 추가 학습을 위한 추천 자료
저자 레퍼런스: Sean Kim
모델 레퍼런스: Hybrid Demucs (Défossez, 2021)
1. 소개
이 튜토리얼은 Hybrid Demucs 모델을 사용한 음악 소스 분리 방법을 보여줍니다. 목표는 믹스된 음악 트랙을 다음과 같은 구성 요소(stem)로 분해하는 것입니다:
- 보컬
- 드럼
- 베이스
- 기타 반주 요소
전체 워크플로는 다음 단계로 구성됩니다:
- Hybrid Demucs 분리 모델 초기화
- 긴 오디오를 오버랩된 청크로 분할
- 청크 단위 모델 추론
- 모든 세그먼트에서 전체 길이 오디오 재구성
- 분리된 stem 내보내기 및 스펙트로그램 시각화
Hybrid Demucs는 원래 Demucs 아키텍처의 향상된 버전입니다.
다음을 결합합니다:
- 파형 도메인의 합성곱 모델링
- 스펙트로그램 도메인의 특징 학습
시간 영역과 주파수 영역 표현을 함께 활용하여 Hybrid Demucs는 기존 접근법보다 훨씬 더 자연스럽고 고충실도의 소스 분리를 달성합니다.
관련 자료:
- Hybrid Demucs 논문: https://arxiv.org/abs/2111.03600
- 공식 저장소: https://github.com/facebookresearch/demucs
2. 환경 설정
필요한 의존성을 설치합니다:
pip install torch torchaudio matplotlib필요한 모듈을 임포트합니다:
import torch
import torchaudio
import matplotlib.pyplot as plt

from IPython.display import Audio
from torchaudio.pipelines import HDEMUCS_HIGH_MUSDB_PLUS
from torchaudio.utils import _download_asset
설치된 버전을 확인합니다:
print(torch.__version__)
print(torchaudio.__version__)
3. Hybrid Demucs 모델 로드
Torchaudio는 사전 학습된 Hybrid Demucs 파이프라인을 기본 제공합니다:
bundle = HDEMUCS_HIGH_MUSDB_PLUS
model = bundle.get_model()
선택된 모델:
- MUSDB18-HQ 데이터셋으로 학습됨
- 추가 전용 증강 데이터 포함
- 고품질 44.1kHz 오디오 처리에 최적화
모델 구성:
- FFT 크기: 4096
- 네트워크 깊이: 6
실행 디바이스를 설정합니다:
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
model.to(device)

sample_rate = bundle.sample_rate

print(f"Sample rate: {sample_rate}")
4. 오디오 분리 파이프라인 구축
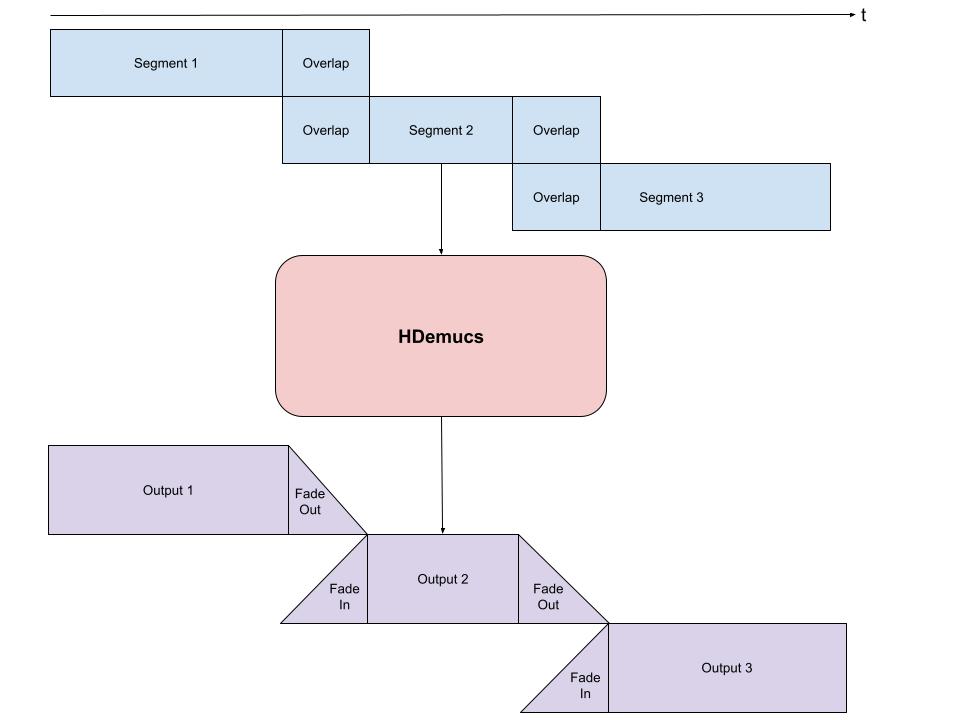
HDemucs는 계산 집약적이고 메모리 요구량이 많기 때문에, 곡 전체를 한 번에 추론하는 것은 비현실적인 경우가 많습니다.
실제 배포 환경에서 긴 오디오는 일반적으로 다음과 같이 처리됩니다:
- 청크 기반 세그먼테이션
- 오버랩되는 윈도우
- 페이드인/페이드아웃 스무딩
이 전략이 필요한 이유:
- 신경망 모델은 세그먼트 경계 근처에서 아티팩트를 생성하는 경향이 있음
- 오버랩 영역은 불연속성과 경계 노이즈를 줄이는 데 도움이 됨
처리 전략은 아래에 나와 있습니다:
4.1 분리 함수 구현
from torchaudio.transforms import Fade


def separate_sources(
    model,
    mix,
    segment=10.0,
    overlap=0.1,
    device=None,
):
    """
    Perform music source separation using chunked inference.

    Args:
        segment: Length of each audio chunk in seconds
        overlap: Overlap ratio between consecutive chunks
        device: Inference device
    """

    if device is None:
        device = mix.device
    else:
        device = torch.device(device)

    batch, channels, length = mix.shape

    chunk_len = int(sample_rate * segment * (1 + overlap))

    start = 0
    end = chunk_len

    overlap_frames = overlap * sample_rate

    fade = Fade(
        fade_in_len=0,
        fade_out_len=int(overlap_frames),
        fade_shape="linear",
    )

    final = torch.zeros(
        batch,
        len(model.sources),
        channels,
        length,
        device=device,
    )

    while start < length - overlap_frames:

        chunk = mix[:, :, start:end]

        with torch.no_grad():
            out = model.forward(chunk)

        out = fade(out)

        final[:, :, :, start:end] += out

        if start == 0:
            fade.fade_in_len = int(overlap_frames)
            start += int(chunk_len - overlap_frames)
        else:
            start += chunk_len

        end += chunk_len

        if end >= length:
            fade.fade_out_len = 0

    return final
5. 스펙트로그램 시각화
스펙트로그램 시각화를 위한 헬퍼 함수를 정의합니다:
def plot_spectrogram(stft, title="Spectrogram"):
    magnitude = stft.abs()

    spectrogram = 20 * torch.log10(
        magnitude + 1e-8
    ).numpy()

    _, axis = plt.subplots(1, 1)

    axis.imshow(
        spectrogram,
        cmap="viridis",
        vmin=-60,
        vmax=0,
        origin="lower",
        aspect="auto",
    )

    axis.set_title(title)

    plt.tight_layout()
6. 소스 분리 실행
Torchaudio에서 제공하는 공식 데모 오디오를 사용합니다:
SAMPLE_SONG = _download_asset(
    "tutorial-assets/hdemucs_mix.wav"
)

waveform, sample_rate = torchaudio.load(SAMPLE_SONG)

waveform = waveform.to(device)

mixture = waveform
추론 파라미터를 설정합니다:
segment = 10
overlap = 0.1
파형을 정규화합니다:
ref = waveform.mean(0)

waveform = (
    waveform - ref.mean()
) / ref.std()
소스 분리를 실행합니다:
sources = separate_sources(
    model,
    waveform[None],
    device=device,
    segment=segment,
    overlap=overlap,
)[0]

sources = sources * ref.std() + ref.mean()
분리된 stem을 저장합니다:
sources_list = model.sources

sources = list(sources)

audios = dict(zip(sources_list, sources))
7. 모델 출력
기본 Hybrid Demucs 모델은 4개의 stem을 생성합니다:
| Stem | 설명 |
|---|---|
| drums | 퍼커션 및 드럼 트랙 |
| bass | 베이스 악기 |
| vocals | 리드 및 코러스 보컬 |
| other | 나머지 반주 |
8. 스펙트로그램 분석
STFT 파라미터를 설정합니다:
N_FFT = 4096
N_HOP = 4

stft = torchaudio.transforms.Spectrogram(
    n_fft=N_FFT,
    hop_length=N_HOP,
    power=None,
)
9. 오디오 세그먼트 추출
150초에서 155초 사이의 세그먼트를 추출합니다:
segment_start = 150
segment_end = 155

frame_start = segment_start * sample_rate
frame_end = segment_end * sample_rate
해당 레퍼런스 stem을 로드합니다:
drums_original = _download_asset(
    "tutorial-assets/hdemucs_drums_segment.wav"
)

bass_original = _download_asset(
    "tutorial-assets/hdemucs_bass_segment.wav"
)

vocals_original = _download_asset(
    "tutorial-assets/hdemucs_vocals_segment.wav"
)

other_original = _download_asset(
    "tutorial-assets/hdemucs_other_segment.wav"
)
예측 세그먼트를 추출합니다:
drums_spec = audios["drums"][:, frame_start:frame_end].cpu()
bass_spec = audios["bass"][:, frame_start:frame_end].cpu()
vocals_spec = audios["vocals"][:, frame_start:frame_end].cpu()
other_spec = audios["other"][:, frame_start:frame_end].cpu()

mix_spec = mixture[:, frame_start:frame_end].cpu()
10. 스펙트로그램 및 오디오 렌더링
시각화와 재생을 위한 유틸리티 함수를 정의합니다:
def output_results(
    original_source: torch.Tensor,
    predicted_source: torch.Tensor,
    source: str,
):

    plot_spectrogram(
        stft(predicted_source)[0],
        f"Spectrogram - {source}"
    )

    return Audio(
        predicted_source,
        rate=sample_rate
    )
11. 믹스 스펙트로그램
plot_spectrogram(
    stft(mix_spec)[0],
    "Spectrogram - Mixture"
)

Audio(mix_spec, rate=sample_rate)
12. 드럼 분리 결과
output_results(
    drums,
    drums_spec,
    "drums"
)
13. 베이스 분리 결과
output_results(
    bass,
    bass_spec,
    "bass"
)
14. 보컬 분리 결과
output_results(
    vocals,
    vocals_spec,
    "vocals"
)
15. 기타 반주 결과
output_results(
    other,
    other_spec,
    "other"
)
16. 전체 오디오 재생
분리된 전체 stem을 들으려면 다음 코드의 주석을 해제하세요:
# Original mixture
# Audio(mixture, rate=sample_rate)

# Drums
# Audio(audios["drums"], rate=sample_rate)

# Bass
# Audio(audios["bass"], rate=sample_rate)

# Vocals
# Audio(audios["vocals"], rate=sample_rate)

# Other accompaniment
# Audio(audios["other"], rate=sample_rate)
17. 결론
Hybrid Demucs는 다음을 통합합니다:
- 시간 영역의 합성곱 모델링
- 주파수 영역의 스펙트로그램 학습
전통적인 소스 분리 접근법과 비교하여 다음을 제공합니다:
- 더 높은 분리 충실도
- 더 깨끗한 보컬 격리
- 반주 누출 감소
이 튜토리얼은 또한 다음을 포함한 실용적인 엔지니어링 전략을 채택합니다:
- 청크 기반 추론
- 오버랩 재구성
- 페이드 스무딩
이러한 기법은 긴 오디오 추론의 과제를 효과적으로 해결하며 실제 배포 시나리오에 매우 적합합니다.
일반적인 응용 분야:
- AI 노래 변환
- 보컬 추출
- 노래방 생성
- 음악 리믹스
- 자동 편곡
- 오디오 후처리
참고 자료
다음 참고 자료는 Hybrid Demucs, 음악 소스 분리, 딥러닝 기반 오디오 처리를 다룹니다.
1. Hybrid Demucs
[1] Hybrid Spectrogram and Waveform Source Separation
저자: Alexandre Défossez
발표: ISMIR 2021 Workshop
연도: 2021
Défossez, A. (2021).
Hybrid Spectrogram and Waveform Source Separation.
arXiv preprint arXiv:2111.03600.
논문:
https://arxiv.org/abs/2111.03600
이 연구는 다음을 결합한 Hybrid Demucs 아키텍처를 소개했습니다:
- 파형 도메인의 합성곱
- 스펙트로그램 도메인의 표현 학습
현재까지도 현대 음악 소스 분리에서 가장 영향력 있는 아키텍처 중 하나입니다.
[2] Music Source Separation in the Waveform Domain
저자: Alexandre Défossez, Nicolas Usunier, Léon Bottou, Francis Bach
학회: ISMIR 2019
연도: 2019
Défossez, A., Usunier, N., Bottou, L., & Bach, F. (2019).
Music Source Separation in the Waveform Domain.
Proceedings of the 20th International Society for Music Information Retrieval Conference (ISMIR).
논문:
https://arxiv.org/abs/1911.13254
이 논문은 원조 Demucs 아키텍처를 소개하고 파형 기반 엔드투엔드 음악 소스 분리를 개척했습니다.
2. 데이터셋 참고 자료
[3] The MUSDB18 Corpus for Music Separation
저자: Zafar Rafii et al.
데이터셋: MUSDB18-HQ
연도: 2017
Rafii, Z., Liutkus, A., Stöter, F.-R., Mimilakis, S. I.,
Bittner, R., & Pardo, B. (2017).
The MUSDB18 Corpus for Music Separation.
데이터셋:
https://zenodo.org/record/3338373
MUSDB18-HQ는 음악 소스 분리 연구에서 가장 널리 채택된 벤치마크 데이터셋 중 하나입니다.
3. PyTorch / Torchaudio 문서
[4] Torchaudio 공식 문서
PyTorch Audio Team.
Torchaudio Documentation.
문서:
https://pytorch.org/audio/stable/index.html
[5] 공식 Hybrid Demucs 튜토리얼
PyTorch Audio Team.
Music Source Separation with Hybrid Demucs.
튜토리얼:
https://docs.pytorch.org/audio/stable/tutorials/hybrid_demucs_tutorial.html
이 글의 구현 구조와 실험 워크플로는 공식 튜토리얼에서 부분적으로 영감을 받았습니다.
4. 음악 소스 분리의 고전 연구
[6] Open-Unmix — A Reference Implementation for Music Source Separation
저자: Fabian-Robert Stöter et al.
저널: Journal of Open Source Software
연도: 2019
Stöter, F.-R., Liutkus, A., & Ito, N. (2019).
The 2018 Signal Separation Evaluation Campaign.
Journal of Open Source Software.
프로젝트:
https://sigsep.github.io/open-unmix/
[7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
저자: Andreas Jansson et al.
학회: ISMIR 2017
Jansson, A., Humphrey, E., Montecchio, N.,
Bittner, R., Kumar, A., & Weyde, T. (2017).
Singing Voice Separation with Deep U-Net Convolutional Networks.
논문:
https://ismir2017.smcnus.org/wp-content/uploads/2017/10/171_Paper.pdf
5. 평가 지표
[8] BSS Eval Metrics
Vincent, E., Gribonval, R., & Févotte, C. (2006).
Performance Measurement in Blind Audio Source Separation.
IEEE Transactions on Audio, Speech, and Language Processing.
논문:
https://ieeexplore.ieee.org/document/1643671
이 연구는 다음을 포함한 소스 분리의 고전적 평가 지표를 도입했습니다:
- SDR (Signal-to-Distortion Ratio)
- SIR (Signal-to-Interference Ratio)
- SAR (Signal-to-Artifacts Ratio)
6. 오디오 처리를 위한 딥러닝
[9] Deep Learning for Audio Signal Processing
Kellman, M., et al.
Deep Learning for Audio Signal Processing.
출판사:
Cambridge University Press
[10] Fundamentals of Music Processing
Müller, M. (2015).
Fundamentals of Music Processing.
Springer.
책 웹사이트:
https://www.music-processing.de/
7. 추가 학습을 위한 추천 자료
| 주제 | 자료 |
|---|---|
| Demucs 공식 저장소 | https://github.com/facebookresearch/demucs |
| PyTorch Audio | https://pytorch.org/audio/stable/index.html |
| 소스 분리 커뮤니티 | https://sigsep.github.io/ |
| MUSDB 데이터셋 | https://zenodo.org/record/3338373 |
| ISMIR 학회 | https://ismir.net/ |