Separação de fontes musicais com IA
Guia prático de separação de fontes musicais com IA usando Hybrid Demucs: divida músicas em voz, bateria, baixo e outros stems, com código completo, espectrogramas e resultados.
Nesta página
- 1. Introdução
- 2. Configuração do ambiente
- 3. Carregamento do modelo Hybrid Demucs
- 4. Construção da pipeline de separação de áudio
- 4.1 Implementação da função de separação
- 5. Visualização do espectrograma
- 6. Execução da separação de fontes
- 7. Saídas do modelo
- 8. Análise do espectrograma
- 9. Extração do segmento de áudio
- 10. Renderização de espectrogramas e áudio
- 11. Espectrograma da mistura
- 12. Resultados da separação de bateria
- 13. Resultados da separação de baixo
- 14. Resultados da separação vocal
- 15. Resultados do acompanhamento restante
- 16. Reprodução do áudio completo
- 17. Conclusão
- Referências
- 1. Hybrid Demucs
- [1] Hybrid Spectrogram and Waveform Source Separation
- [2] Music Source Separation in the Waveform Domain
- 2. Referências de datasets
- [3] The MUSDB18 Corpus for Music Separation
- 3. Documentação PyTorch / Torchaudio
- [4] Documentação oficial do Torchaudio
- [5] Tutorial oficial do Hybrid Demucs
- 4. Pesquisa clássica em separação de fontes musicais
- [6] Open-Unmix — A Reference Implementation for Music Source Separation
- [7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
- 5. Métricas de avaliação
- [8] BSS Eval Metrics
- 6. Deep learning para processamento de áudio
- [9] Deep Learning for Audio Signal Processing
- [10] Fundamentals of Music Processing
- 7. Recursos recomendados para estudo avançado
Referência do autor: Sean Kim
Referência do modelo: Hybrid Demucs (Défossez, 2021)
1. Introdução
Este tutorial demonstra como realizar a separação de fontes musicais usando o modelo Hybrid Demucs. O objetivo é decompor uma faixa musical mixada em seus stems constituintes, incluindo:
- Vocais
- Bateria
- Baixo
- Outros componentes de acompanhamento
O fluxo de trabalho completo consiste nas seguintes etapas:
- Inicialização do modelo de separação Hybrid Demucs
- Divisão do áudio longo em chunks sobrepostos
- Inferência do modelo chunk a chunk
- Reconstrução do áudio completo a partir de todos os segmentos
- Exportação dos stems separados e visualização dos espectrogramas
O Hybrid Demucs é uma versão aprimorada da arquitetura Demucs original.
Ele combina:
- Modelagem convolucional no domínio da forma de onda
- Aprendizado de características no domínio do espectrograma
Ao aproveitar conjuntamente as representações dos domínios do tempo e da frequência, o Hybrid Demucs alcança uma separação de fontes significativamente mais natural e de maior fidelidade do que as abordagens convencionais.
Recursos relacionados:
- Paper do Hybrid Demucs: https://arxiv.org/abs/2111.03600
- Repositório oficial: https://github.com/facebookresearch/demucs
2. Configuração do ambiente
Instale as dependências necessárias:
pip install torch torchaudio matplotlibImporte os módulos necessários:
import torch
import torchaudio
import matplotlib.pyplot as plt

from IPython.display import Audio
from torchaudio.pipelines import HDEMUCS_HIGH_MUSDB_PLUS
from torchaudio.utils import _download_asset
Verifique as versões instaladas:
print(torch.__version__)
print(torchaudio.__version__)
3. Carregamento do modelo Hybrid Demucs
O Torchaudio fornece uma pipeline Hybrid Demucs pré-treinada pronta para uso:
bundle = HDEMUCS_HIGH_MUSDB_PLUS
model = bundle.get_model()
O modelo selecionado:
- Foi treinado no dataset MUSDB18-HQ
- Inclui dados de aumento proprietários adicionais
- É otimizado para processamento de áudio de alta qualidade a 44,1 kHz
Configuração do modelo:
- Tamanho da FFT: 4096
- Profundidade da rede: 6
Configure o dispositivo de execução:
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
model.to(device)

sample_rate = bundle.sample_rate

print(f"Sample rate: {sample_rate}")
4. Construção da pipeline de separação de áudio
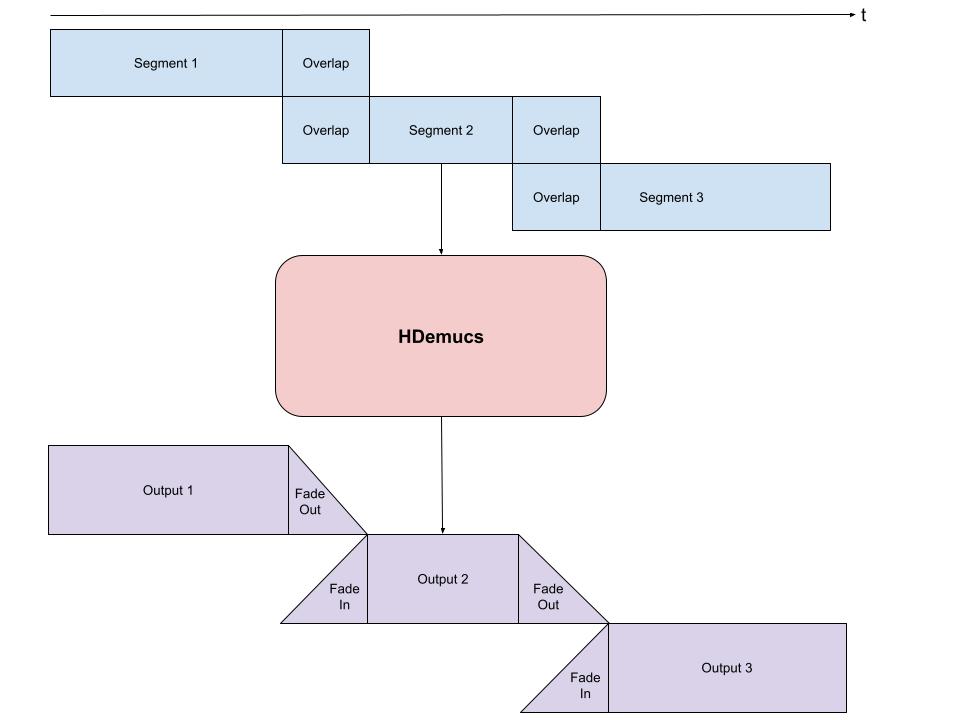
Como o HDemucs é intensivo em computação e exige muita memória, executar a inferência sobre uma música inteira em uma única passada costuma ser impraticável.
Em implantações reais, o áudio longo é tipicamente processado com:
- Segmentação baseada em chunks
- Janelas sobrepostas
- Suavização com fade-in / fade-out
Essa estratégia é necessária porque:
- Modelos neurais tendem a gerar artefatos próximos às fronteiras dos segmentos
- Regiões sobrepostas ajudam a reduzir descontinuidades e ruído de fronteira
A estratégia de processamento é ilustrada abaixo:
4.1 Implementação da função de separação
from torchaudio.transforms import Fade


def separate_sources(
    model,
    mix,
    segment=10.0,
    overlap=0.1,
    device=None,
):
    """
    Perform music source separation using chunked inference.

    Args:
        segment: Length of each audio chunk in seconds
        overlap: Overlap ratio between consecutive chunks
        device: Inference device
    """

    if device is None:
        device = mix.device
    else:
        device = torch.device(device)

    batch, channels, length = mix.shape

    chunk_len = int(sample_rate * segment * (1 + overlap))

    start = 0
    end = chunk_len

    overlap_frames = overlap * sample_rate

    fade = Fade(
        fade_in_len=0,
        fade_out_len=int(overlap_frames),
        fade_shape="linear",
    )

    final = torch.zeros(
        batch,
        len(model.sources),
        channels,
        length,
        device=device,
    )

    while start < length - overlap_frames:

        chunk = mix[:, :, start:end]

        with torch.no_grad():
            out = model.forward(chunk)

        out = fade(out)

        final[:, :, :, start:end] += out

        if start == 0:
            fade.fade_in_len = int(overlap_frames)
            start += int(chunk_len - overlap_frames)
        else:
            start += chunk_len

        end += chunk_len

        if end >= length:
            fade.fade_out_len = 0

    return final
5. Visualização do espectrograma
Defina uma função auxiliar para a visualização do espectrograma:
def plot_spectrogram(stft, title="Spectrogram"):
    magnitude = stft.abs()

    spectrogram = 20 * torch.log10(
        magnitude + 1e-8
    ).numpy()

    _, axis = plt.subplots(1, 1)

    axis.imshow(
        spectrogram,
        cmap="viridis",
        vmin=-60,
        vmax=0,
        origin="lower",
        aspect="auto",
    )

    axis.set_title(title)

    plt.tight_layout()
6. Execução da separação de fontes
Use o áudio de demonstração oficial fornecido pelo Torchaudio:
SAMPLE_SONG = _download_asset(
    "tutorial-assets/hdemucs_mix.wav"
)

waveform, sample_rate = torchaudio.load(SAMPLE_SONG)

waveform = waveform.to(device)

mixture = waveform
Configure os parâmetros de inferência:
segment = 10
overlap = 0.1
Normalize a forma de onda:
ref = waveform.mean(0)

waveform = (
    waveform - ref.mean()
) / ref.std()
Execute a separação de fontes:
sources = separate_sources(
    model,
    waveform[None],
    device=device,
    segment=segment,
    overlap=overlap,
)[0]

sources = sources * ref.std() + ref.mean()
Armazene os stems separados:
sources_list = model.sources

sources = list(sources)

audios = dict(zip(sources_list, sources))
7. Saídas do modelo
O modelo Hybrid Demucs padrão produz quatro stems:
| Stem | Descrição |
|---|---|
| drums | Percussão e faixas de bateria |
| bass | Instrumentos de baixo |
| vocals | Vocais principais e de apoio |
| other | Acompanhamento restante |
8. Análise do espectrograma
Configure os parâmetros de STFT:
N_FFT = 4096
N_HOP = 4

stft = torchaudio.transforms.Spectrogram(
    n_fft=N_FFT,
    hop_length=N_HOP,
    power=None,
)
9. Extração do segmento de áudio
Extraia o segmento entre 150 s e 155 s:
segment_start = 150
segment_end = 155

frame_start = segment_start * sample_rate
frame_end = segment_end * sample_rate
Carregue os stems de referência correspondentes:
drums_original = _download_asset(
    "tutorial-assets/hdemucs_drums_segment.wav"
)

bass_original = _download_asset(
    "tutorial-assets/hdemucs_bass_segment.wav"
)

vocals_original = _download_asset(
    "tutorial-assets/hdemucs_vocals_segment.wav"
)

other_original = _download_asset(
    "tutorial-assets/hdemucs_other_segment.wav"
)
Extraia os segmentos previstos:
drums_spec = audios["drums"][:, frame_start:frame_end].cpu()
bass_spec = audios["bass"][:, frame_start:frame_end].cpu()
vocals_spec = audios["vocals"][:, frame_start:frame_end].cpu()
other_spec = audios["other"][:, frame_start:frame_end].cpu()

mix_spec = mixture[:, frame_start:frame_end].cpu()
10. Renderização de espectrogramas e áudio
Defina uma função de utilidade para visualização e reprodução:
def output_results(
    original_source: torch.Tensor,
    predicted_source: torch.Tensor,
    source: str,
):

    plot_spectrogram(
        stft(predicted_source)[0],
        f"Spectrogram - {source}"
    )

    return Audio(
        predicted_source,
        rate=sample_rate
    )
11. Espectrograma da mistura
plot_spectrogram(
    stft(mix_spec)[0],
    "Spectrogram - Mixture"
)

Audio(mix_spec, rate=sample_rate)
12. Resultados da separação de bateria
output_results(
    drums,
    drums_spec,
    "drums"
)
13. Resultados da separação de baixo
output_results(
    bass,
    bass_spec,
    "bass"
)
14. Resultados da separação vocal
output_results(
    vocals,
    vocals_spec,
    "vocals"
)
15. Resultados do acompanhamento restante
output_results(
    other,
    other_spec,
    "other"
)
16. Reprodução do áudio completo
Para ouvir os stems separados completos, descomente o código a seguir:
# Original mixture
# Audio(mixture, rate=sample_rate)

# Drums
# Audio(audios["drums"], rate=sample_rate)

# Bass
# Audio(audios["bass"], rate=sample_rate)

# Vocals
# Audio(audios["vocals"], rate=sample_rate)

# Other accompaniment
# Audio(audios["other"], rate=sample_rate)
17. Conclusão
O Hybrid Demucs integra:
- Modelagem convolucional no domínio do tempo
- Aprendizado de espectrogramas no domínio da frequência
Comparado às abordagens tradicionais de separação de fontes, ele oferece:
- Maior fidelidade de separação
- Isolamento vocal mais limpo
- Menor vazamento do acompanhamento
Este tutorial adota, além disso, estratégias práticas de engenharia, incluindo:
- Inferência baseada em chunks
- Reconstrução com sobreposição
- Suavização com fade
Essas técnicas abordam eficazmente os desafios da inferência em áudio longo e são altamente adequadas para cenários de implantação reais.
Aplicações típicas incluem:
- Conversão de voz cantada com IA
- Extração vocal
- Geração de karaokê
- Remix de música
- Arranjo automático
- Pós-processamento de áudio
Referências
As referências a seguir cobrem o Hybrid Demucs, a separação de fontes musicais e o processamento de áudio baseado em deep learning.
1. Hybrid Demucs
[1] Hybrid Spectrogram and Waveform Source Separation
Autor: Alexandre Défossez
Evento: ISMIR 2021 Workshop
Ano: 2021
Défossez, A. (2021).
Hybrid Spectrogram and Waveform Source Separation.
arXiv preprint arXiv:2111.03600.
Paper:
https://arxiv.org/abs/2111.03600
Este trabalho introduziu a arquitetura Hybrid Demucs, que combina:
- Convolução no domínio da forma de onda
- Aprendizado de representações no domínio do espectrograma
Ela permanece uma das arquiteturas mais influentes na separação de fontes musicais moderna.
[2] Music Source Separation in the Waveform Domain
Autores: Alexandre Défossez, Nicolas Usunier, Léon Bottou, Francis Bach
Conferência: ISMIR 2019
Ano: 2019
Défossez, A., Usunier, N., Bottou, L., & Bach, F. (2019).
Music Source Separation in the Waveform Domain.
Proceedings of the 20th International Society for Music Information Retrieval Conference (ISMIR).
Paper:
https://arxiv.org/abs/1911.13254
Este paper introduziu a arquitetura Demucs original e foi pioneiro na separação de fontes musicais end-to-end baseada em formas de onda.
2. Referências de datasets
[3] The MUSDB18 Corpus for Music Separation
Autores: Zafar Rafii et al.
Dataset: MUSDB18-HQ
Ano: 2017
Rafii, Z., Liutkus, A., Stöter, F.-R., Mimilakis, S. I.,
Bittner, R., & Pardo, B. (2017).
The MUSDB18 Corpus for Music Separation.
Dataset:
https://zenodo.org/record/3338373
O MUSDB18-HQ é um dos datasets de benchmark mais adotados na pesquisa de separação de fontes musicais.
3. Documentação PyTorch / Torchaudio
[4] Documentação oficial do Torchaudio
PyTorch Audio Team.
Torchaudio Documentation.
Documentação:
https://pytorch.org/audio/stable/index.html
[5] Tutorial oficial do Hybrid Demucs
PyTorch Audio Team.
Music Source Separation with Hybrid Demucs.
Tutorial:
https://docs.pytorch.org/audio/stable/tutorials/hybrid_demucs_tutorial.html
A estrutura de implementação e o fluxo experimental apresentados neste artigo são parcialmente inspirados no tutorial oficial.
4. Pesquisa clássica em separação de fontes musicais
[6] Open-Unmix — A Reference Implementation for Music Source Separation
Autores: Fabian-Robert Stöter et al.
Journal: Journal of Open Source Software
Ano: 2019
Stöter, F.-R., Liutkus, A., & Ito, N. (2019).
The 2018 Signal Separation Evaluation Campaign.
Journal of Open Source Software.
Projeto:
https://sigsep.github.io/open-unmix/
[7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
Autores: Andreas Jansson et al.
Conferência: ISMIR 2017
Jansson, A., Humphrey, E., Montecchio, N.,
Bittner, R., Kumar, A., & Weyde, T. (2017).
Singing Voice Separation with Deep U-Net Convolutional Networks.
Paper:
https://ismir2017.smcnus.org/wp-content/uploads/2017/10/171_Paper.pdf
5. Métricas de avaliação
[8] BSS Eval Metrics
Vincent, E., Gribonval, R., & Févotte, C. (2006).
Performance Measurement in Blind Audio Source Separation.
IEEE Transactions on Audio, Speech, and Language Processing.
Paper:
https://ieeexplore.ieee.org/document/1643671
Este trabalho introduziu várias métricas clássicas de avaliação para separação de fontes, incluindo:
- SDR (Signal-to-Distortion Ratio)
- SIR (Signal-to-Interference Ratio)
- SAR (Signal-to-Artifacts Ratio)
6. Deep learning para processamento de áudio
[9] Deep Learning for Audio Signal Processing
Kellman, M., et al.
Deep Learning for Audio Signal Processing.
Editora:
Cambridge University Press
[10] Fundamentals of Music Processing
Müller, M. (2015).
Fundamentals of Music Processing.
Springer.
Site do livro:
https://www.music-processing.de/
7. Recursos recomendados para estudo avançado
| Tópico | Recurso |
|---|---|
| Repositório oficial do Demucs | https://github.com/facebookresearch/demucs |
| PyTorch Audio | https://pytorch.org/audio/stable/index.html |
| Comunidade de separação de fontes | https://sigsep.github.io/ |
| Dataset MUSDB | https://zenodo.org/record/3338373 |
| Sociedade ISMIR | https://ismir.net/ |