Разделение музыкальных источников с помощью ИИ
Практическое руководство по ИИ-разделению музыкальных стемов с Hybrid Demucs: разделяйте песни на вокал, барабаны, бас и другие дорожки — с полным кодом, спектрограммами и результатами.
На этой странице
- 1. Введение
- 2. Настройка окружения
- 3. Загрузка модели Hybrid Demucs
- 4. Построение pipeline разделения аудио
- 4.1 Реализация функции разделения
- 5. Визуализация спектрограммы
- 6. Запуск разделения источников
- 7. Выходы модели
- 8. Анализ спектрограммы
- 9. Извлечение аудиосегмента
- 10. Отрисовка спектрограмм и аудио
- 11. Спектрограмма смеси
- 12. Результаты разделения барабанов
- 13. Результаты разделения баса
- 14. Результаты разделения вокала
- 15. Результаты разделения прочего аккомпанемента
- 16. Воспроизведение полного аудио
- 17. Заключение
- Ссылки
- 1. Hybrid Demucs
- [1] Hybrid Spectrogram and Waveform Source Separation
- [2] Music Source Separation in the Waveform Domain
- 2. Ссылки на датасеты
- [3] The MUSDB18 Corpus for Music Separation
- 3. Документация PyTorch / Torchaudio
- [4] Официальная документация Torchaudio
- [5] Официальный туториал Hybrid Demucs
- 4. Классические исследования разделения музыкальных источников
- [6] Open-Unmix — A Reference Implementation for Music Source Separation
- [7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
- 5. Метрики оценки
- [8] BSS Eval Metrics
- 6. Глубокое обучение для обработки аудио
- [9] Deep Learning for Audio Signal Processing
- [10] Fundamentals of Music Processing
- 7. Рекомендуемые ресурсы для дальнейшего изучения
Автор-референс: Sean Kim
Референс модели: Hybrid Demucs (Défossez, 2021)
1. Введение
Этот туториал демонстрирует, как выполнить разделение музыкальных источников с помощью модели Hybrid Demucs. Цель — разложить смешанную музыкальную дорожку на её составные стемы, включая:
- Вокал
- Барабаны
- Бас
- Прочие аккомпанирующие компоненты
Полный воркфлоу состоит из следующих этапов:
- Инициализация модели разделения Hybrid Demucs
- Разбиение длинного аудио на перекрывающиеся чанки
- Инференс модели по чанкам
- Реконструкция полноформатного аудио из всех сегментов
- Экспорт разделённых стемов и визуализация спектрограмм
Hybrid Demucs — это улучшенная версия оригинальной архитектуры Demucs.
Она объединяет:
- Свёрточное моделирование в области волновой формы
- Обучение признаков в области спектрограммы
Совместно используя представления во временной и частотной областях, Hybrid Demucs достигает значительно более естественного и точного разделения источников по сравнению с традиционными подходами.
Связанные ресурсы:
- Статья Hybrid Demucs: https://arxiv.org/abs/2111.03600
- Официальный репозиторий: https://github.com/facebookresearch/demucs
2. Настройка окружения
Установите необходимые зависимости:
pip install torch torchaudio matplotlibИмпортируйте нужные модули:
import torch
import torchaudio
import matplotlib.pyplot as plt

from IPython.display import Audio
from torchaudio.pipelines import HDEMUCS_HIGH_MUSDB_PLUS
from torchaudio.utils import _download_asset
Проверьте установленные версии:
print(torch.__version__)
print(torchaudio.__version__)
3. Загрузка модели Hybrid Demucs
Torchaudio предоставляет предобученную pipeline Hybrid Demucs из коробки:
bundle = HDEMUCS_HIGH_MUSDB_PLUS
model = bundle.get_model()
Выбранная модель:
- Обучена на датасете MUSDB18-HQ
- Включает дополнительные проприетарные данные аугментации
- Оптимизирована для высококачественной обработки аудио на 44,1 кГц
Конфигурация модели:
- Размер FFT: 4096
- Глубина сети: 6
Настройте устройство выполнения:
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
model.to(device)

sample_rate = bundle.sample_rate

print(f"Sample rate: {sample_rate}")
4. Построение pipeline разделения аудио
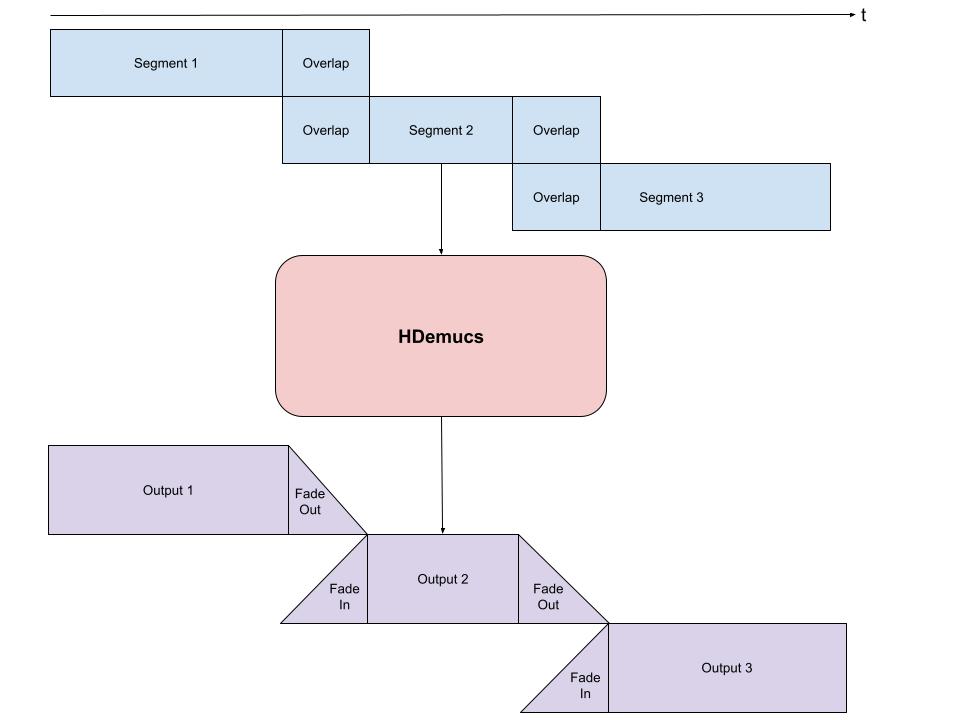
Поскольку HDemucs вычислительно интенсивна и требовательна к памяти, инференс целой песни за один проход зачастую непрактичен.
В реальных развёртываниях длинное аудио обычно обрабатывается с помощью:
- Сегментации по чанкам
- Перекрывающихся окон
- Сглаживания fade-in / fade-out
Эта стратегия необходима, потому что:
- Нейросетевые модели склонны создавать артефакты возле границ сегментов
- Перекрывающиеся области помогают уменьшить разрывы и граничный шум
Стратегия обработки проиллюстрирована ниже:
4.1 Реализация функции разделения
from torchaudio.transforms import Fade


def separate_sources(
    model,
    mix,
    segment=10.0,
    overlap=0.1,
    device=None,
):
    """
    Perform music source separation using chunked inference.

    Args:
        segment: Length of each audio chunk in seconds
        overlap: Overlap ratio between consecutive chunks
        device: Inference device
    """

    if device is None:
        device = mix.device
    else:
        device = torch.device(device)

    batch, channels, length = mix.shape

    chunk_len = int(sample_rate * segment * (1 + overlap))

    start = 0
    end = chunk_len

    overlap_frames = overlap * sample_rate

    fade = Fade(
        fade_in_len=0,
        fade_out_len=int(overlap_frames),
        fade_shape="linear",
    )

    final = torch.zeros(
        batch,
        len(model.sources),
        channels,
        length,
        device=device,
    )

    while start < length - overlap_frames:

        chunk = mix[:, :, start:end]

        with torch.no_grad():
            out = model.forward(chunk)

        out = fade(out)

        final[:, :, :, start:end] += out

        if start == 0:
            fade.fade_in_len = int(overlap_frames)
            start += int(chunk_len - overlap_frames)
        else:
            start += chunk_len

        end += chunk_len

        if end >= length:
            fade.fade_out_len = 0

    return final
5. Визуализация спектрограммы
Определите вспомогательную функцию для визуализации спектрограммы:
def plot_spectrogram(stft, title="Spectrogram"):
    magnitude = stft.abs()

    spectrogram = 20 * torch.log10(
        magnitude + 1e-8
    ).numpy()

    _, axis = plt.subplots(1, 1)

    axis.imshow(
        spectrogram,
        cmap="viridis",
        vmin=-60,
        vmax=0,
        origin="lower",
        aspect="auto",
    )

    axis.set_title(title)

    plt.tight_layout()
6. Запуск разделения источников
Используйте официальное демо-аудио от Torchaudio:
SAMPLE_SONG = _download_asset(
    "tutorial-assets/hdemucs_mix.wav"
)

waveform, sample_rate = torchaudio.load(SAMPLE_SONG)

waveform = waveform.to(device)

mixture = waveform
Настройте параметры инференса:
segment = 10
overlap = 0.1
Нормализуйте волновую форму:
ref = waveform.mean(0)

waveform = (
    waveform - ref.mean()
) / ref.std()
Запустите разделение источников:
sources = separate_sources(
    model,
    waveform[None],
    device=device,
    segment=segment,
    overlap=overlap,
)[0]

sources = sources * ref.std() + ref.mean()
Сохраните разделённые стемы:
sources_list = model.sources

sources = list(sources)

audios = dict(zip(sources_list, sources))
7. Выходы модели
Стандартная модель Hybrid Demucs создаёт четыре стема:
| Stem | Описание |
|---|---|
| drums | Ударные и барабанные дорожки |
| bass | Басовые инструменты |
| vocals | Основной и бэк-вокал |
| other | Оставшийся аккомпанемент |
8. Анализ спектрограммы
Настройте параметры STFT:
N_FFT = 4096
N_HOP = 4

stft = torchaudio.transforms.Spectrogram(
    n_fft=N_FFT,
    hop_length=N_HOP,
    power=None,
)
9. Извлечение аудиосегмента
Извлеките сегмент между 150 с и 155 с:
segment_start = 150
segment_end = 155

frame_start = segment_start * sample_rate
frame_end = segment_end * sample_rate
Загрузите соответствующие референсные стемы:
drums_original = _download_asset(
    "tutorial-assets/hdemucs_drums_segment.wav"
)

bass_original = _download_asset(
    "tutorial-assets/hdemucs_bass_segment.wav"
)

vocals_original = _download_asset(
    "tutorial-assets/hdemucs_vocals_segment.wav"
)

other_original = _download_asset(
    "tutorial-assets/hdemucs_other_segment.wav"
)
Извлеките предсказанные сегменты:
drums_spec = audios["drums"][:, frame_start:frame_end].cpu()
bass_spec = audios["bass"][:, frame_start:frame_end].cpu()
vocals_spec = audios["vocals"][:, frame_start:frame_end].cpu()
other_spec = audios["other"][:, frame_start:frame_end].cpu()

mix_spec = mixture[:, frame_start:frame_end].cpu()
10. Отрисовка спектрограмм и аудио
Определите utility-функцию для визуализации и воспроизведения:
def output_results(
    original_source: torch.Tensor,
    predicted_source: torch.Tensor,
    source: str,
):

    plot_spectrogram(
        stft(predicted_source)[0],
        f"Spectrogram - {source}"
    )

    return Audio(
        predicted_source,
        rate=sample_rate
    )
11. Спектрограмма смеси
plot_spectrogram(
    stft(mix_spec)[0],
    "Spectrogram - Mixture"
)

Audio(mix_spec, rate=sample_rate)
12. Результаты разделения барабанов
output_results(
    drums,
    drums_spec,
    "drums"
)
13. Результаты разделения баса
output_results(
    bass,
    bass_spec,
    "bass"
)
14. Результаты разделения вокала
output_results(
    vocals,
    vocals_spec,
    "vocals"
)
15. Результаты разделения прочего аккомпанемента
output_results(
    other,
    other_spec,
    "other"
)
16. Воспроизведение полного аудио
Чтобы прослушать полные разделённые стемы, раскомментируйте следующий код:
# Original mixture
# Audio(mixture, rate=sample_rate)

# Drums
# Audio(audios["drums"], rate=sample_rate)

# Bass
# Audio(audios["bass"], rate=sample_rate)

# Vocals
# Audio(audios["vocals"], rate=sample_rate)

# Other accompaniment
# Audio(audios["other"], rate=sample_rate)
17. Заключение
Hybrid Demucs объединяет:
- Свёрточное моделирование во временной области
- Обучение спектрограмм в частотной области
По сравнению с традиционными подходами к разделению источников он предлагает:
- Более высокую точность разделения
- Более чистую изоляцию вокала
- Меньшее просачивание аккомпанемента
Этот туториал дополнительно использует практические инженерные стратегии, включая:
- Инференс по чанкам
- Реконструкцию с перекрытием
- Сглаживание фейдами
Эти техники эффективно решают проблемы инференса на длинном аудио и отлично подходят для реальных сценариев развёртывания.
Типичные применения:
- ИИ-конвертация певческого голоса
- Извлечение вокала
- Создание караоке
- Музыкальные ремиксы
- Автоматическая аранжировка
- Аудиопостобработка
Ссылки
Следующие источники охватывают Hybrid Demucs, разделение музыкальных источников и обработку аудио на основе глубокого обучения.
1. Hybrid Demucs
[1] Hybrid Spectrogram and Waveform Source Separation
Автор: Alexandre Défossez
Площадка: ISMIR 2021 Workshop
Год: 2021
Défossez, A. (2021).
Hybrid Spectrogram and Waveform Source Separation.
arXiv preprint arXiv:2111.03600.
Статья:
https://arxiv.org/abs/2111.03600
Эта работа представила архитектуру Hybrid Demucs, объединяющую:
- Свёртку в области волновой формы
- Обучение представлений в области спектрограммы
Она остаётся одной из самых влиятельных архитектур в современном разделении музыкальных источников.
[2] Music Source Separation in the Waveform Domain
Авторы: Alexandre Défossez, Nicolas Usunier, Léon Bottou, Francis Bach
Конференция: ISMIR 2019
Год: 2019
Défossez, A., Usunier, N., Bottou, L., & Bach, F. (2019).
Music Source Separation in the Waveform Domain.
Proceedings of the 20th International Society for Music Information Retrieval Conference (ISMIR).
Статья:
https://arxiv.org/abs/1911.13254
Эта статья представила оригинальную архитектуру Demucs и заложила основу разделения музыкальных источников end-to-end в области волновой формы.
2. Ссылки на датасеты
[3] The MUSDB18 Corpus for Music Separation
Авторы: Zafar Rafii et al.
Датасет: MUSDB18-HQ
Год: 2017
Rafii, Z., Liutkus, A., Stöter, F.-R., Mimilakis, S. I.,
Bittner, R., & Pardo, B. (2017).
The MUSDB18 Corpus for Music Separation.
Датасет:
https://zenodo.org/record/3338373
MUSDB18-HQ — один из самых широко используемых бенчмарк-датасетов в исследованиях разделения музыкальных источников.
3. Документация PyTorch / Torchaudio
[4] Официальная документация Torchaudio
PyTorch Audio Team.
Torchaudio Documentation.
Документация:
https://pytorch.org/audio/stable/index.html
[5] Официальный туториал Hybrid Demucs
PyTorch Audio Team.
Music Source Separation with Hybrid Demucs.
Туториал:
https://docs.pytorch.org/audio/stable/tutorials/hybrid_demucs_tutorial.html
Структура реализации и экспериментальный воркфлоу в этой статье частично вдохновлены официальным туториалом.
4. Классические исследования разделения музыкальных источников
[6] Open-Unmix — A Reference Implementation for Music Source Separation
Авторы: Fabian-Robert Stöter et al.
Журнал: Journal of Open Source Software
Год: 2019
Stöter, F.-R., Liutkus, A., & Ito, N. (2019).
The 2018 Signal Separation Evaluation Campaign.
Journal of Open Source Software.
Проект:
https://sigsep.github.io/open-unmix/
[7] Wave-U-Net: A Multi-Scale Neural Network for End-to-End Audio Source Separation
Авторы: Andreas Jansson et al.
Конференция: ISMIR 2017
Jansson, A., Humphrey, E., Montecchio, N.,
Bittner, R., Kumar, A., & Weyde, T. (2017).
Singing Voice Separation with Deep U-Net Convolutional Networks.
Статья:
https://ismir2017.smcnus.org/wp-content/uploads/2017/10/171_Paper.pdf
5. Метрики оценки
[8] BSS Eval Metrics
Vincent, E., Gribonval, R., & Févotte, C. (2006).
Performance Measurement in Blind Audio Source Separation.
IEEE Transactions on Audio, Speech, and Language Processing.
Статья:
https://ieeexplore.ieee.org/document/1643671
Эта работа ввела несколько классических метрик оценки разделения источников, включая:
- SDR (Signal-to-Distortion Ratio)
- SIR (Signal-to-Interference Ratio)
- SAR (Signal-to-Artifacts Ratio)
6. Глубокое обучение для обработки аудио
[9] Deep Learning for Audio Signal Processing
Kellman, M., et al.
Deep Learning for Audio Signal Processing.
Издатель:
Cambridge University Press
[10] Fundamentals of Music Processing
Müller, M. (2015).
Fundamentals of Music Processing.
Springer.
Сайт книги:
https://www.music-processing.de/
7. Рекомендуемые ресурсы для дальнейшего изучения
| Тема | Ресурс |
|---|---|
| Официальный репозиторий Demucs | https://github.com/facebookresearch/demucs |
| PyTorch Audio | https://pytorch.org/audio/stable/index.html |
| Сообщество разделения источников | https://sigsep.github.io/ |
| Датасет MUSDB | https://zenodo.org/record/3338373 |
| Общество ISMIR | https://ismir.net/ |